채팅 시스템 설계: 웹소켓 연결부터 메시지 수락, 전달, 재접속 복구까지
스터디에서 『가상 면접 사례로 배우는 대규모 시스템 설계 기초』 12장 채팅 시스템 설계를 공부했습니다. 발표 대본과 화이트보드 준비 문서를 만들면서 책의 설계를 그대로 외우기보다, 책이 정하지 않고 넘어간 두 가지를 직접 정해 보고 싶었습니다. 서버가 송신자에게 "받았다"고 답하는 시점은 언제인지, 그리고 연결이 끊겼다가 다시 붙은 단말은 무엇을 채워야 하는지입니다.
글에서는 책에 있는 내용을 원문, 제가 스터디에서 더한 판단을 원문 밖 확장, 계산을 위해 정한 값을 설계 가정으로 표시했습니다. 부하 테스트나 운영 지표로만 정할 수 있는 값은 무엇을 재면 정해지는지 함께 적었습니다.
메시지 한 건으로 보는 전체 구조
이 글에서 정한 메시지 경로를 먼저 그리면 다음과 같습니다. 책의 채팅 서버를 연결을 맡는 WebSocket Gateway와 대화별 순서를 맡는 Conversation Shard로 나눴습니다. 이 편에서는 복제 로그의 구현 기술을 정하지 않고, 3편에서 Kafka를 대입합니다.
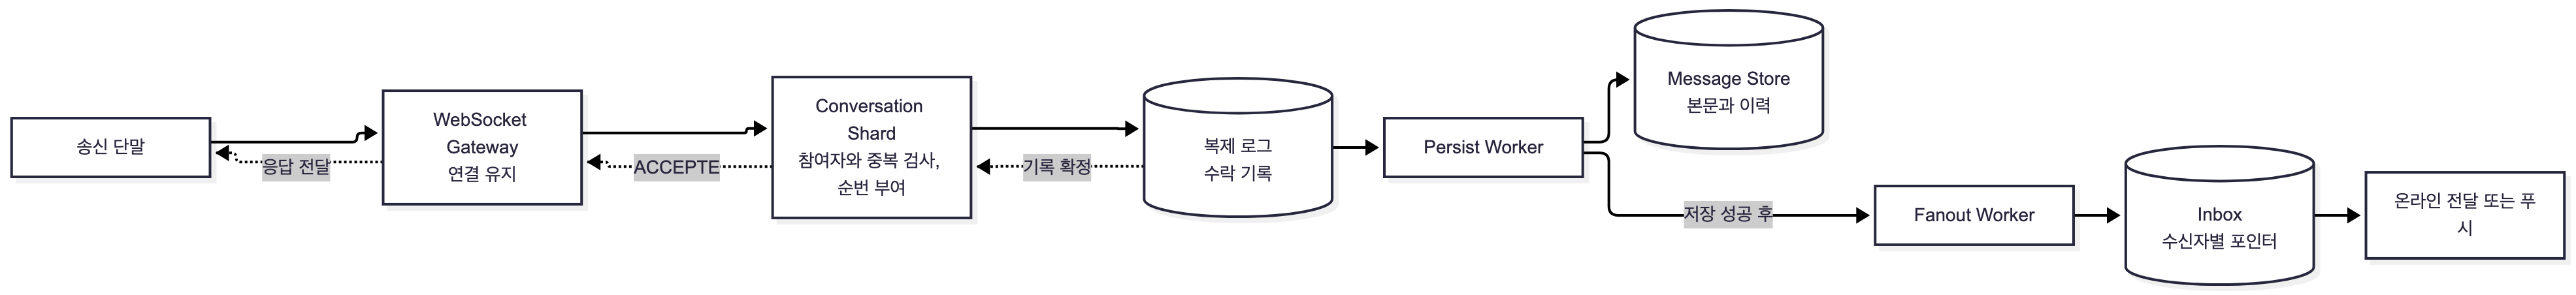
송신자에게 주는 ACCEPTED는 복제 로그 기록이 확정됐다는 뜻입니다. 상대에게 보낼 작업은 Message Store 저장이 성공한 뒤에 시작합니다. 이 두 경계와 재접속 시 Inbox에서 빠진 항목을 채우는 절차가 1편의 중심입니다. 대화 담당자를 안전하게 교체하는 방법은 2편에서 다룹니다.
서버가 클라이언트에게 먼저 보내는 네 가지 방법
채팅에서 메시지를 보내는 쪽은 평범한 HTTP 요청으로도 충분합니다. 어려운 쪽은 받는 쪽입니다. 일반적인 HTTP 요청과 응답에서는 클라이언트가 먼저 요청하므로, 서버가 원하는 때에 메시지를 보내려면 연결을 열어 두는 별도 방식이 필요합니다. 책은 이 문제를 푸는 방법으로 폴링, 롱 폴링, 웹소켓을 설명합니다(원문). 저는 여기에 SSE를 더해 네 가지를 비교했습니다(원문 밖 확장).
- 폴링(short polling) 은 클라이언트가 일정 주기로 "새 메시지 있나요?"를 묻는 방식입니다. 구현은 가장 단순하지만, 자주 물으면 빈 응답이 늘고 드물게 물으면 메시지가 늦게 도착합니다.
- 롱 폴링(long polling) 은 서버가 새 메시지가 생기거나 타임아웃이 날 때까지 응답을 붙잡아 두는 방식입니다. 빈 응답은 줄지만, 책이 지적하듯 메시지를 받은 서버와 수신자의 롱 폴링 연결을 가진 서버가 다를 수 있고, 서버는 클라이언트가 떠났는지 알기 어렵습니다(원문).
- SSE(Server-Sent Events) 는 HTTP 연결 하나를 열어 두고 서버가 클라이언트 쪽으로만 이벤트를 흘려보내는 HTML 표준입니다. 브라우저의 EventSource는 연결이 닫히면 스스로 다시 연결합니다. 방향이 한쪽이라 클라이언트가 보내는 것은 별도 HTTP 요청으로 처리합니다.
- 웹소켓(WebSocket) 은 HTTP 요청으로 시작해 핸드셰이크를 거친 뒤, 연결 하나로 양쪽이 아무 때나 메시지를 주고받는 프로토콜입니다. 80, 443 포트를 그대로 쓰므로 방화벽 환경에서도 잘 동작한다고 책은 설명합니다(원문)
책이 그린 웹소켓 연결 과정은 짧습니다. 클라이언트가 GET으로 시작하고, 핸드셰이크가 끝나면 같은 연결로 양쪽이 메시지를 보냅니다.
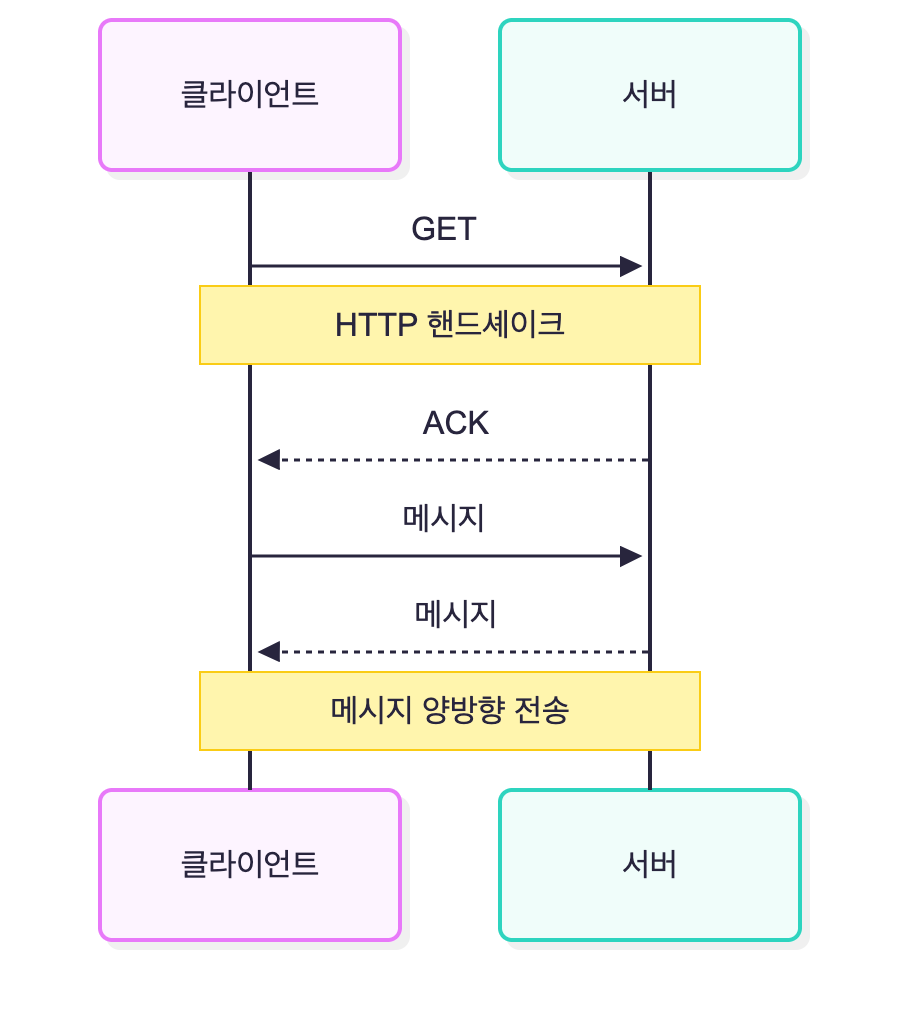
그림에서 볼 것은 두 가지입니다. 연결을 여는 쪽은 클라이언트이고, 한 번 열린 뒤에는 서버도 먼저 보낼 수 있습니다. 여기서 ACK는 연결 수립에 대한 응답이지, 뒤에서 다룰 메시지 전달 확인과는 다른 것입니다.
책이 "HTTP 핸드셰이크"로 줄여 그린 단계를 웹소켓 표준 RFC 6455는 Upgrade 헤더가 붙은 GET 요청과 101 Switching Protocols 응답으로 정의합니다. 표준 문서의 예시는 다음과 같습니다.
GET /chat HTTP/1.1
Host: server.example.com
Upgrade: websocket
Connection: Upgrade
Sec-WebSocket-Key: dGhlIHNhbXBsZSBub25jZQ==
Sec-WebSocket-Version: 13

HTTP/1.1 101 Switching Protocols
Upgrade: websocket
Connection: Upgrade
Sec-WebSocket-Accept: s3pPLMBiTxaQ9kYGzzhZRbK+xOo=
| 방식 | 해결하는 것 | 고려해야하는 것 | 선택 기준 |
| 폴링 | 가장 단순한 구현 | 빈 요청과 지연 사이의 선택 | 갱신이 드물고 실시간성이 낮을 때 |
| 롱 폴링 | 폴링보다 적은 빈 응답 | 타임아웃과 재연결, 서버 간 연결 매칭 | 웹소켓을 쓸 수 없는 환경 |
| SSE와 HTTP | 서버 푸시와 자동 재연결 | 송신은 별도 API | 알림, 피드처럼 서버에서 클라이언트로 가는 흐름이 대부분일 때 |
| 웹소켓 | 연결 하나로 양방향 통신 | 연결 상태, heartbeat, 흐름 제어를 직접 관리 | 양방향 이벤트가 잦은 채팅 |
제가 채팅에 웹소켓을 고른 이유는 채팅에서 오가는 이벤트가 대부분 양방향이기 때문입니다. 메시지 송신과 수신만이 아니라 "받았다"는 전달 확인, "읽었다"는 읽음 표시, 연결이 살아 있는지 확인하는 heartbeat(연결 확인 신호)가 양쪽으로 오갑니다. 롱 폴링은 응답이 끝날 때마다 HTTP 요청을 다시 보내야 합니다. 이때 TCP와 TLS 연결은 재사용할 수 있으므로 매번 새 연결을 맺는 것은 아닙니다. 웹소켓은 열린 연결에서 양방향 메시지를 계속 주고받을 수 있어, 이런 요청 반복을 줄입니다.
이 선택이 틀리는 경우도 적어 두었습니다. 하루에 몇 번 오는 알림만 받는 앱이라면 연결을 계속 붙잡아 두는 비용이 얻는 것보다 큽니다. 그때는 SSE나 모바일 푸시 알림과 필요할 때의 HTTP 조회가 더 쌉니다. 모바일에서는 웹소켓만 있는 것도 아닙니다. Facebook은 2014년 글에서 Messenger 모바일 앱이 MQTT로 변경분을 받는다고 설명합니다. 웹소켓이 유리한 조건은 "양방향 이벤트가 잦다"는 요구사항이지 채팅이라는 이름이 아닙니다.
책의 개략 설계와 1:1 메시지 흐름
통신 방식을 정한 뒤 책은 시스템을 무상태 서비스, 상태 유지 서비스, 제3자 서비스 연동으로 나누고, 이를 서버 단위로 묶은 개략 설계를 제시합니다(원문). 아래는 책의 개략 설계를 옮긴 그림입니다. 책에 없는 컴포넌트는 넣지 않았습니다.

그림에서 볼 것은 세 가지입니다.
- 이 책의 개략도에서는 HTTP 요청만 로드밸런서를 지나고, 웹소켓은 사용자 단말과 실시간 서비스 사이에 직접 그려져 있습니다. 실제 배포에서는 웹소켓 연결도 로드밸런서를 거칠 수 있습니다. 연결 상태를 유지하는 일은 채팅 서버와 접속 상태 서버가 맡습니다.
- 로그인, 회원가입, 프로필 같은 나머지 요청은 로드밸런서 뒤의 무상태 API 서버가 받습니다. 알림 서버는 API 서버에서만 요청을 받습니다.
- 채팅 이력은 키-값 저장소에 둡니다. 저장소 세 개는 한 묶음으로 그려져 있고, 알림 서버, API 서버, 채팅 서버, 접속 상태 서버가 모두 이 묶음으로 이어집니다. 어느 저장소가 어느 서버 몫인지는 그림이 정하지 않습니다.
책은 이어서 사용자 A가 B에게 1:1 메시지를 보낼 때의 흐름을 여섯 단계로 설명합니다. 이 흐름에서 사용자별 메시지 동기화 큐가 처음 나옵니다.
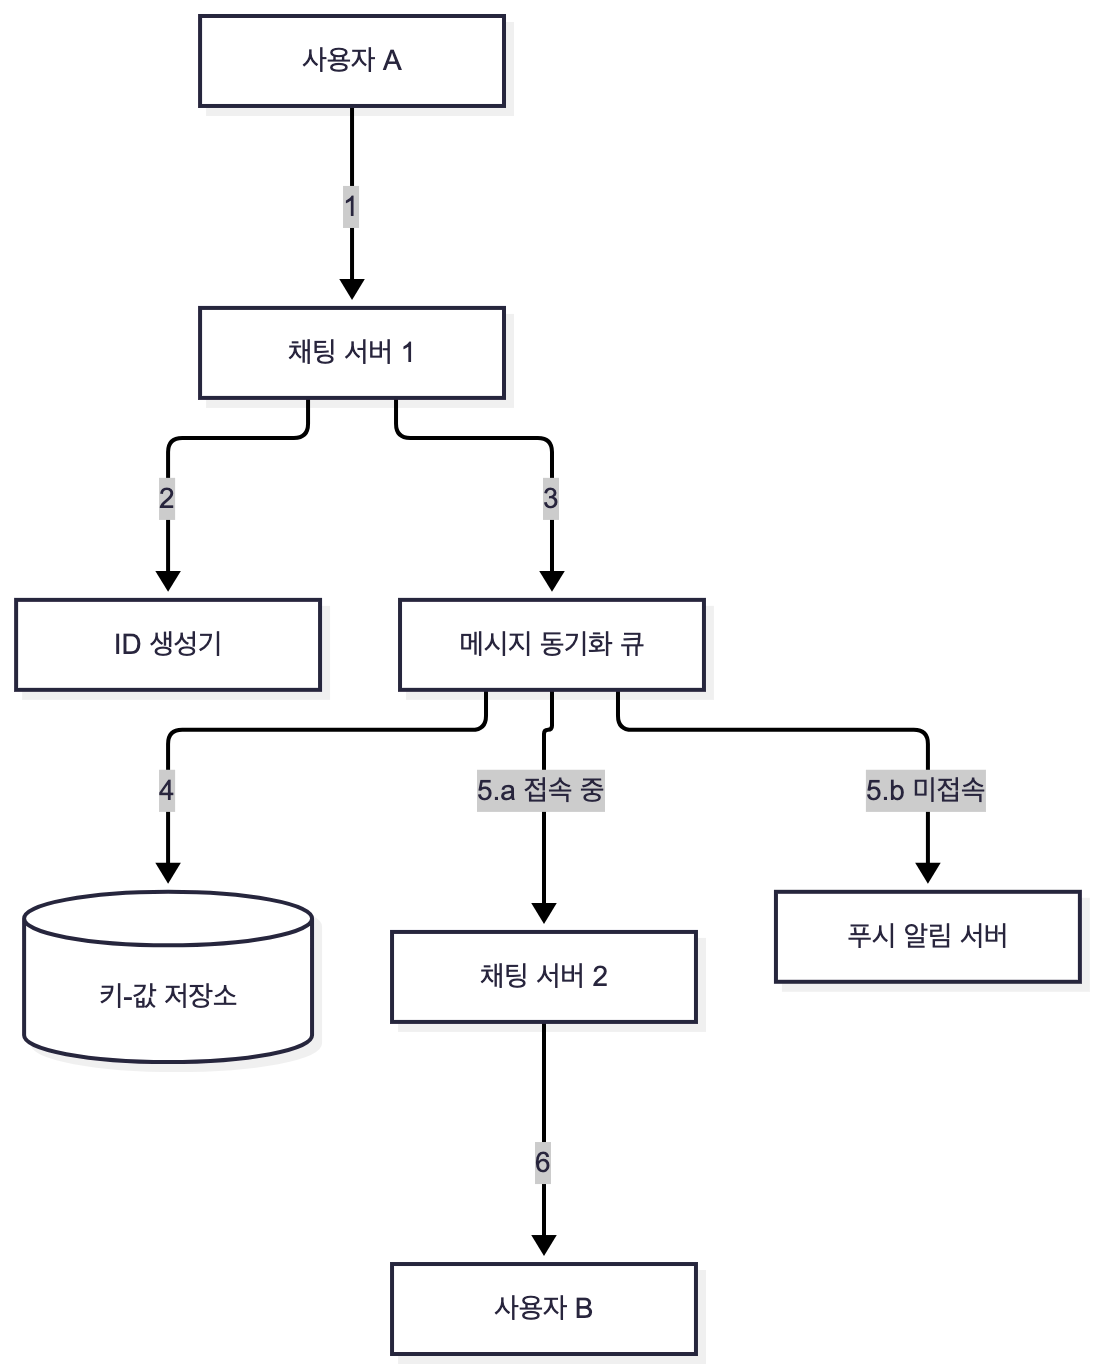
채팅 서버 1이 ID를 정하고, 메시지를 동기화 큐로 보내고, 큐에서 저장과 전달이 일어납니다. B가 접속 중이면 B가 붙은 채팅 서버 2로, 아니면 푸시 알림으로 갑니다.
이 그림을 여러 번 보면서 책이 정하지 않은 것이 세 가지 보였습니다.
- A에게 돌아가는 응답이 없습니다. A의 화면에서 "전송 중"이 "전송됨"으로 바뀌는 시점이 없고, 2단계와 3단계 사이에 채팅 서버 1이 죽으면 메시지가 어떻게 되는지도 알 수 없습니다.
- 4단계 저장과 5단계 전달의 선후가 없습니다. 저장이 끝난 뒤 전달하는지, 동시에 하는지 번호로만 나뉘어 있습니다.
- 5단계에서 B가 접속 중인지를 누가 판단하는지 없습니다.
책은 마무리에서 메시지 재전송에 "재시도나 큐"를 쓴다고 한 줄로 적습니다(원문). 아래는 책의 개략 설계를 옮긴 그림입니다. 책에 없는 컴포넌트는 넣지 않았습니다.. 수단은 있지만 무엇을 기준으로 재시도할지는 없습니다. 제 확장 설계의 대부분은 이 세 가지 빈칸을 채우는 데 쓰였습니다. 그 전에 규모부터 계산했습니다.
용량 추정: 책에서 온 숫자와 제가 가정한 숫자
책이 정한 규모는 DAU(하루 활성 사용자) 5천만 명, 그룹 최대 100명, 메시지 최대 100,000자, 채팅 이력 영구 보관입니다. 그리고 서버 메모리를 개략 계산하면서 동시 접속자를 100만 명, 연결당 메모리를 10KB로 두고 10GB면 모든 연결을 담을 수 있다고 씁니다(원문). 하루 메시지 수, 피크 배수, 메시지 크기는 책에 없으므로 제가 정했습니다. 용량 추정에서 얻고 싶었던 것은 정확한 서버 대수가 아니라 어느 부분이 먼저 병목이 되는지였습니다.
| 변수 | 값 | 출처와 계산 |
| DAU | 50,000,000명 | 원문 |
| 1인당 하루 메시지 | 40건 | 설계 가정 |
| 하루 메시지 | 2,000,000,000건 | 5천만 × 40 |
| 평균 유입 | 약 23,148건/초 | 20억 ÷ 86,400초 |
| 피크 배수 | 평균의 10배 | 설계 가정 |
| 피크 유입 | 약 231,480건/초 | 23,148 × 10 |
| 동시 접속(책) | 1,000,000개 | 원문. DAU의 2% |
| 피크 동시 연결(확장 설계) | 5,000,000개 | 설계 가정. 5천만 × 10% |
1인당 하루 40건. 책에 값이 없어서 공개 자료로 크기를 맞춰 보았습니다. WhatsApp은 2014년 Erlang Factory 발표에서 월 사용자 4억 6,500만 명, 하루 서버 유입 메시지 190억 건과 수신자 쪽으로 나간 메시지 400억 건을 밝혔습니다. 유입 190억 건을 월 사용자 수로 나누면 한 명당 하루 약 41건입니다(190억 ÷ 4억 6,500만). 이는 DAU가 아닌 월 사용자로 나눈 값이고, 그 서비스의 사용 패턴을 지금 설계하는 서비스에 그대로 적용할 수도 없습니다. 여기서는 송신량의 크기를 가늠하는 참고치로만 쓰고 40건을 설계 가정으로 둡니다. 1인당 80건이면 하루 40억 건, 피크 약 46만 건/초로 아래 계산이 모두 두 배가 됩니다. 기존 서비스 로그에서 사용자별 하루 송신 건수의 평균과 p99를 뽑으면 정해집니다.
피크 배수 10. 채팅의 피크 대 평균 비율은 책에도 제가 찾은 공개 자료에도 없어서, 여유를 크게 둔 값으로 잡았습니다. 여러 시간대에 사용자가 퍼진 서비스에서 실제 비율이 3이라면 피크는 약 69,444건/초이고, 10배 기준으로 증설하면 세 배 넘게 과하게 삽니다. 반대로 한 나라에 몰린 서비스는 새해 0시처럼 몇 분 동안 몰리는 순간이 있어 10을 넘을 수 있습니다. LINE이 새해 트래픽 대비를 따로 글로 쓴 것도 이 때문입니다. 1분 단위 최대 송신 건수를 하루 평균으로 나눠 재야 정해집니다.
동시 접속 100만과 5백만. 이 차이는 계산 전체에 퍼지므로 따로 표로 나눴습니다. 책은 동시 접속 100만을 근거 없이 가정합니다. 저는 DAU에 피크 동시 접속률 10%를 곱해 5백만으로 잡았습니다. 모바일 앱이 백그라운드에서도 연결을 오래 유지하면 동시 연결 비율이 2%보다 훨씬 높아지기 때문입니다. WhatsApp은 같은 2014년 발표에서 동시 연결 1억 4,700만 개를 밝혔는데, 월 사용자의 약 32%입니다. 반대로 앱이 백그라운드로 가면 연결을 끊고 푸시로만 깨우는 정책이라면 책의 2%가 맞고, 5백만 기준 설계는 다섯 배 과합니다. 동시 연결 수는 제품의 백그라운드 연결 정책이 정하므로, 그 정책을 먼저 정하고 피크 시간대 동시 연결 수를 DAU로 나눠 잽니다.
| 항목 | 책의 가정(100만) | 확장 설계 가정(5백만) |
| 연결 메모리(연결당 10KB) | 10GB | 50GB |
| Gateway 수(노드당 50,000, 여유 1.5) | 30대 | 150대 |
| heartbeat(책의 예시 5초 주기) | 초당 200,000건 | 초당 1,000,000건 |
| heartbeat(확장 설계 20초 주기) | 초당 50,000건 | 초당 250,000건 |
같은 공식에서 동시 접속률 하나가 다섯 배 차이를 만듭니다. 두 가정을 섞으면 더 크게 틀립니다. 책의 5초 주기에 확장 설계의 5백만 연결을 넣으면 초당 100만 건이 나오는데, 이는 어느 쪽 가정에도 속하지 않는 숫자입니다. 이 글의 이후 계산은 모두 5백만 기준입니다.
메모리만 보면 어느 쪽이든 적은 서버로 담을 수 있는 규모입니다. 책도 그래서 서버 한 대 설계를 제시한 뒤, 그 서버가 단일 장애 지점(SPOF, 한 곳이 죽으면 전체가 멈추는 곳)이 된다는 이유로 받아들이기 어렵다고 설명합니다(원문). 서버당 연결 수의 상한을 정하는 것은 메모리가 아니라 한 대가 죽을 때 한꺼번에 끊기는 연결 수와 그 재접속 부하입니다.
저장 용량. 메시지 한 건을 본문과 메타데이터를 합쳐 평균 1KB로 가정하면(설계 가정) 하루 약 2TB, 1년 약 730TB입니다. 복제본을 3개 두면 1년에 약 2.19PB입니다. 인덱스, 백업, 압축 효과는 넣지 않았습니다. 복제본 3개도 설계 가정인데, Facebook은 2018년에 Messenger 저장소를 HBase에서 MyRocks로 옮기면서 복제 계수를 6에서 3으로 줄였다고 밝혔습니다. 같은 데이터라도 저장 구조에 따라 복제본 수가 달라진다는 뜻입니다. 리전 두 곳에 각각 3개씩 두면 1년에 4.38PB가 됩니다. 이 숫자에서 나온 판단은 메시지 저장소는 여러 노드로 나눠 늘릴 수 있어야 하고, 영구 보관은 오래된 이력을 값싼 저장소로 옮기는 단계를 따로 두어야 한다는 것입니다.
최대 메시지 크기. 평균 1KB는 최대 크기가 아닙니다. 책의 상한은 100,000"자"인데, UTF-8에서 문자 하나는 1바이트에서 4바이트까지 차지합니다(RFC 3629). 한글 음절은 3바이트, 이모지 대부분은 4바이트입니다. 4바이트 문자가 대부분이면 본문만 약 400KB로, 평균의 400배입니다. "한 글자"를 무엇으로 세는지도 문제입니다. 피부색이 붙은 엄지 이모지는 화면에서는 한 글자지만 코드 포인트 두 개(U+1F44D, U+1F3FD)라 8바이트입니다. Gateway는 받은 프레임을 메모리에 올리므로, 상한을 문자 수로만 걸면 큰 프레임 몇 개로 메모리를 채울 수 있습니다. 그래서 외부 계약은 문자 수와 함께 인코딩한 바이트 수(encoded_bytes)로 상한을 걸고, 웹소켓 프레임 크기와 압축을 푼 뒤의 크기까지 제한하기로 했습니다(원문 밖 확장). Gateway, 로그, 메시지 저장소가 같은 상한을 쓰는지는 상한 바로 위아래 크기의 메시지로 부하 테스트를 해서 확인합니다.
연결 서버 수. 서버 한 대가 유지할 수 있는 연결 수는 언어, TLS, 메시지 빈도, 버퍼, 커널 설정에 따라 크게 달라지므로 공식을 먼저 두었습니다.
필요 Gateway 수 = 피크 동시 연결 수 ÷ 노드당 안전 연결 수 × 여유 계수
              = 5,000,000 ÷ 50,000 × 1.5 = 150대
노드당 50,000은 공개 사례보다 훨씬 보수적인 값입니다. WhatsApp은 2012년 블로그에서 서버 한 대(24코어, 약 103GB RAM)로 TCP 연결 2,277,845개를 유지했다고 밝혔고, 2014년 발표에서는 chat 서버 한 대가 폰 약 100만 대를 맡는다고 했습니다. Discord는 2017년 글에서 세션 서버 한 대가 최대 50만 세션을 맡는다고 썼고, 카카오톡은 2022년 발표에서 서버당 세션 50만 이상을 밝혔습니다. 실험 최대치(227만)와 운영치(약 100만)가 다르다는 점도 WhatsApp 자료에서 보입니다.
그런데도 50,000으로 둔 이유는 노드당 연결을 늘리면 잃는 것이 있기 때문입니다. 두 배인 100,000으로 잡으면 서버는 75대로 줄지만, 한 대가 죽을 때 끊기는 연결과 재접속 부하도 두 배가 됩니다. 절반인 25,000이면 300대가 필요합니다. 부하 테스트에서 재접속 폭주, 큰 메시지, 가비지 컬렉션 멈춤을 함께 넣고, p99 지연이 목표를 넘기 직전의 연결 수를 찾은 뒤, 그 한 대가 죽었을 때의 재접속을 인증과 동기화 서버가 받아 낼 수 있는 수까지 줄여서 정합니다. 평균 CPU가 낮다는 이유로 연결 상한을 올리지 않습니다.
여유 계수 1.5는 가용 영역(AZ, 전원과 네트워크가 분리된 데이터센터 묶음) 세 곳에 고르게 두고 그중 한 곳이 통째로 빠져도 남은 두 곳이 피크를 받는 값입니다. AZ가 n곳이고 한 곳 장애를 견디려면 n ÷ (n - 1)이 필요하므로, 세 곳이면 1.5입니다. AZ가 두 곳이면 2.0이 필요하고, 배포로 일부 노드를 비우는 동안 AZ 장애가 겹치면 1.5로도 모자랍니다.
heartbeat. 5백만 연결이 20초마다 heartbeat를 보내면(설계 가정) 초당 25만 건으로, 피크 메시지 유입(약 23만 건/초)과 비슷합니다. 20초는 중간 장비가 쉬는 연결을 끊기 전에 트래픽을 흘려 연결을 살려 두는 역할도 합니다. AWS ALB는 공식 문서 기준으로 유휴 타임아웃 기본값이 60초이므로 20초면 충분합니다. 그러나 통신사 NAT가 20초보다 짧게 쉬는 연결을 지우는 망이라면 20초 주기로는 연결을 살리지 못하고, 30초 안팎이라면 heartbeat 하나만 늦어도 끊깁니다. 반대로 책의 예시인 5초로 줄이면 초당 100만 건이 되고 모바일 무선 모듈을 자주 깨워 배터리를 씁니다. 대상 망별로 heartbeat 없이 연결이 살아 있는 최대 유휴 시간을 재고, 그중 가장 짧은 값보다 작게 둡니다. 초당 25만 건을 모두 중앙 저장소에 하나씩 쓰면 메시지보다 접속 상태 기록이 더 큰 쓰기 부하가 될 수 있다는 점은 뒤에서 접속 상태를 설계할 때 다시 씁니다.
연결 상태, 메시지 상태, 대화 상태를 나눠서 보기
용량을 계산하고 나니, 책의 채팅 서버 하나가 성격이 전혀 다른 상태를 함께 들고 있다는 점이 보였습니다. 그래서 책의 구성 요소를 따라가면서 시스템이 들고 있는 상태를 세 가지로 나눴습니다(원문 밖 확장).
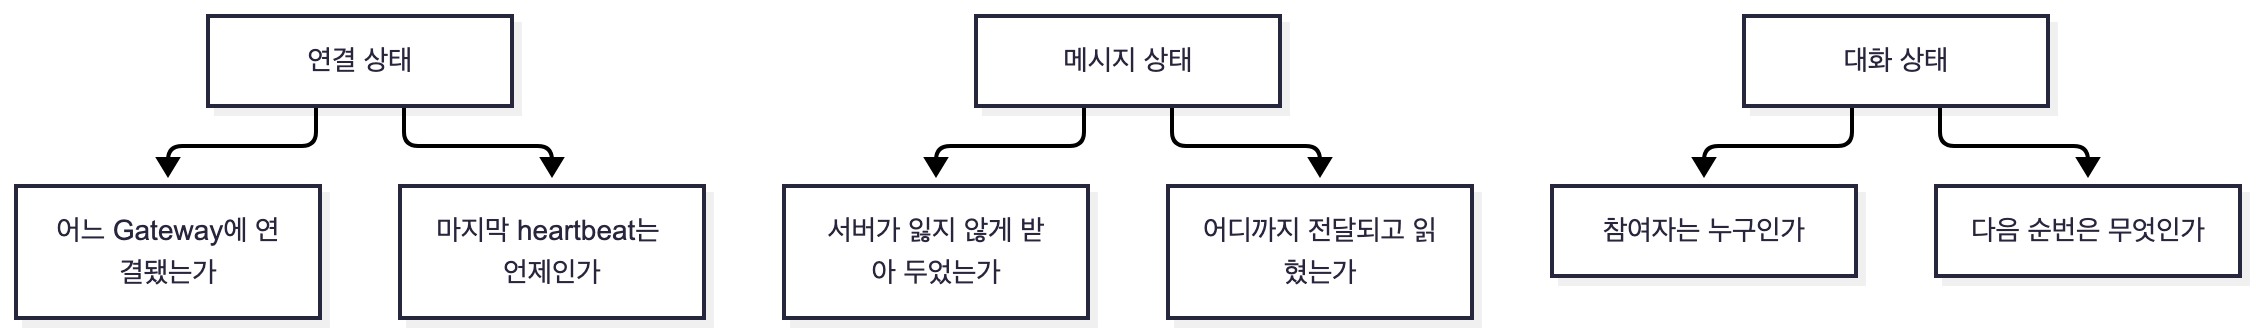
그림에서 볼 것은 세 상태의 수명이 다르다는 점입니다. 연결은 끊겼다 붙었다를 반복하는 일시적인 것이고, 메시지는 한 번 받았다고 알려 주면 끝까지 지켜야 하는 것이며, 대화 상태는 순서를 정하는 데 필요한 것입니다. 웹소켓이 끊겨도 서버가 이미 받아 둔 메시지는 사라지면 안 되고, 반대로 웹소켓이 살아 있다고 해서 메시지가 저장됐다는 뜻도 아닙니다. 그래서 연결을 다루는 부분, 메시지를 처리하는 부분, 저장하는 부분을 따로 늘리고 따로 복구할 수 있게 나눴습니다.
먼저 정한 불변 조건 다섯 개
구성 요소를 그리기 전에 시스템이 끝까지 지켜야 할 규칙을 먼저 적었습니다(원문 밖 확장). 뒤의 설계 선택은 모두 이 다섯 개를 지키는지로 판단했습니다.
- I1. 성공 응답을 받은 메시지는 복구할 수 있다. Gateway 메모리에만 올라간 상태에서는 성공 응답을 보내지 않습니다. 여러 노드에 복제된 로그에 기록된 뒤에 보냅니다.
- I2. 같은 대화의 메시지는 하나의 서버 순서로 모인다. 클라이언트 시각은 믿지 않습니다. 한 대화의 명령은 한 곳에서 차례로 처리하고 대화 안의 순번을 붙입니다.
- I3. 재시도는 허용하되 사용자에게 두 번 보이지 않는다. 단말이 만든 ID로 중복을 가려냅니다. 내부 전달은 "적어도 한 번"을 허용하고 저장과 표시 단계에서 중복을 없앱니다.
- I4. 접속 상태는 정확한 사실이 아니라 만료되는 추정값이다. 네트워크가 잠깐 끊겼다고 곧바로 로그아웃으로 보지 않습니다.
- I5. 재접속은 연결을 되살리는 일이 아니라 빠진 구간을 채우는 일이다. 새 서버에 붙은 단말은 이전 서버의 메모리에 기대지 않고, 자기가 마지막으로 받은 위치 이후를 다시 가져옵니다.
I1은 앞에서 본 첫 번째 빈칸(응답 시점)에, I5는 재접속 문제에 대한 답입니다. I2의 "한 곳에서 차례로 처리한다"를 어떻게 만드는지는 이 글에서 다루지 않고, 대화마다 순서를 정하는 담당자가 하나 있다는 전제만 씁니다.
컴포넌트를 나눈 기준
불변 조건을 지키도록 책의 채팅 서버, 키-값 저장소, 동기화 큐를 역할별로 더 잘게 나눈 전체 구조입니다(원문 밖 확장).
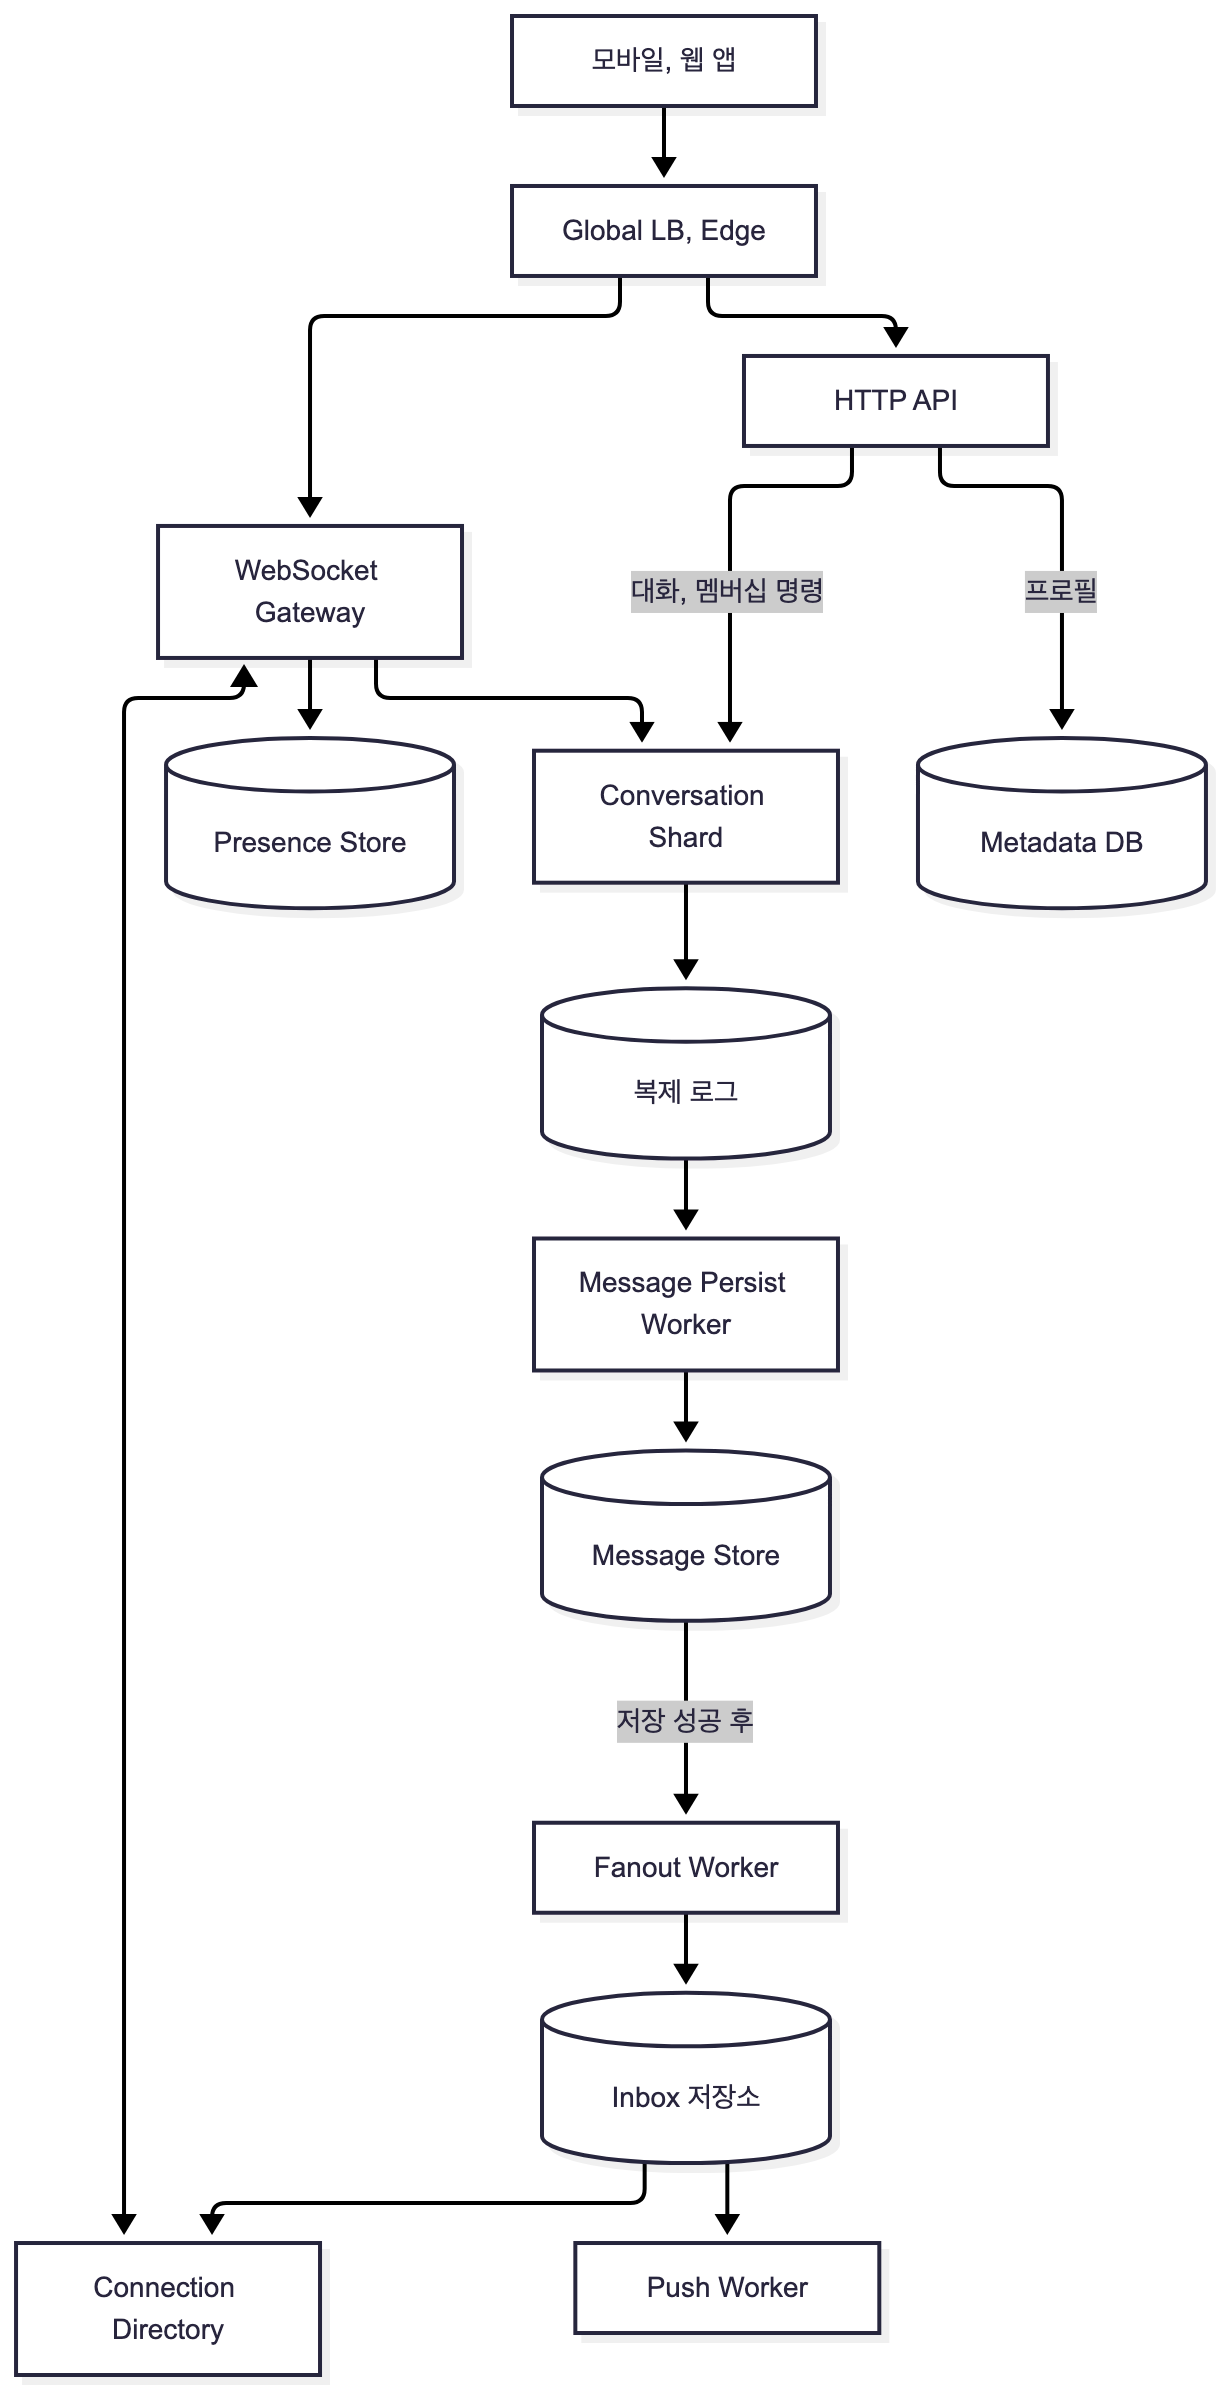
그림에서 볼 것은 세 가지입니다. 책의 채팅 서버가 WebSocket Gateway와 Conversation Shard 둘로 나뉘었습니다. 메시지는 복제 로그를 지나 저장소에 저장된 뒤에야 Fanout Worker로 넘어갑니다. 수신자에게 보낼 것은 Inbox 저장소에 먼저 기록됩니다. 각 선택의 이유는 아래에서 차례로 씁니다.
Gateway와 Conversation Shard를 나눈 이유. WebSocket Gateway는 단말과의 연결을 유지하고 인증, 크기 검사, heartbeat를 처리합니다. Conversation Shard는 대화 단위로 명령을 받아 참여자인지 확인하고, 중복을 걸러 내고, 대화 안의 순번을 붙입니다.
- 근거: 늘려야 하는 이유가 다릅니다. Gateway 수는 동시 연결 수(5백만)가 정하고, Shard 처리량은 메시지 유입(피크 231,480건/초)이 정합니다. 앱만 켜 두고 메시지는 적은 밤 시간과, 연결 수는 비슷한데 메시지가 몰리는 새해 0시가 따로 있습니다. 공개된 구조도 같은 방향입니다. Slack은 2023년 글에서 웹소켓 구독을 들고 있는 Gateway Server와 채널의 메시지를 맡는 Channel Server를 따로 설명합니다. LINE의 게이트웨이와 talk-server, 카카오톡의 Relay와 Session Manager도 연결과 처리를 나눈 구조입니다.
- 트레이드오프: 메시지 한 건이 Gateway에서 Shard로 가는 네트워크 구간이 하나 늘고 그만큼 수락이 늦어집니다. 대신 Gateway 배포와 Shard 이동을 따로 할 수 있습니다.
- 장애: Gateway 한 대가 죽으면 그 대의 연결만 끊기고 대화의 순서 상태는 남습니다. Shard 노드가 죽으면 연결은 살아 있는데 그 노드가 맡던 대화만 송신이 멈춥니다. 사용자에게는 "연결됨" 표시인데 "전송 중" 표시가 계속 도는 것으로 보입니다.
- 반례: 하루 메시지가 수백만 건이고 연결이 수만 개인 서비스라면 두 계층을 나눌 이유가 없습니다. 서버 몇 대가 연결과 순서를 함께 처리해도 충분하고, 나누면 네트워크 구간과 운영 부담만 늡니다. 그래서 구현 순서도 처음에는 나누지 않고 시작하도록 적었습니다.
아래는 두 컴포넌트의 책임 경계를 표시한 의사코드입니다. 실제 요청 처리 구현을 보여 주는 코드는 아닙니다.
# Gateway: 연결은 들고 있지만 순서는 정하지 않는다
on_message_send(conn, frame):
    reject if not valid(conn.token) or frame.encoded_bytes > MAX_ENCODED_BYTES
    node = route_table.owner(conversation_of(frame))
    send(conn, rpc(node, SendCommand(frame)))       # ACCEPTED 또는 오류

# Conversation Shard: 연결을 모른다
handle(cmd):
    mailbox(cmd.conversation_id).enqueue(cmd)       # 대화별로 차례로 처리
서비스 탐색은 제품이 아니라 역할로 봤습니다. 책은 아파치 주키퍼(ZooKeeper)에 채팅 서버를 등록해 두고, 사용자의 위치와 서버 용량을 기준으로 적합한 채팅 서버를 골라 준다고 설명합니다(원문). 책이 근거로 든 Facebook의 2010년 글도 주키퍼 위에 사용자 위치를 찾는 서비스를 만들었다고 씁니다. 여기서 제가 가져온 것은 주키퍼라는 제품이 아니라 "오래 유지할 연결을 맺기 전에 건강하고 여유 있는 서버를 고르는 역할"입니다. 이 설계에서는 가까운 정상 리전을 고르고, 연결 수와 이벤트 루프 지연과 배포로 비우는 중인지를 보고 Gateway를 고른 뒤, 실제 연결 위치를 만료 시간이 있는 항목으로 Connection Directory에 등록합니다. API가 Gateway 주소를 돌려주거나 L7 로드밸런서가 서버 묶음을 고르는 방식으로도 같은 역할을 할 수 있습니다.
가지지 않아야 할 책임. 컴포넌트마다 맡는 일과 함께 맡지 않아야 할 일을 적었습니다. 맡지 않는 일을 적어 두면 같은 책임이 두 컴포넌트로 퍼지는 것을 막을 수 있습니다.
| 컴포넌트 | 맡는 일 | 맡지 않는 일 |
| WebSocket Gateway | 연결 유지, 인증, 프레임 검증, heartbeat | 메시지의 최종 보관 |
| Connection Directory | 사용자와 단말이 어느 Gateway에 붙어 있는지 조회 | 영구 사용자 상태 |
| Conversation Shard | 멤버십 확인, 중복 제거, 대화별 순번 | 오래된 이력 조회 |
| 복제 로그 | 수락한 명령을 잃지 않게 보관, 재처리 기준 | 사용자 검색 |
| Message Persist Worker | 로그를 읽어 Message Store에 중복 없이 저장 | 수신자 연결 위치 결정 |
| Message Store | 메시지 본문과 대화별 이력 | 사용자별 새 이벤트 순서 |
| Fanout Worker | 저장된 메시지의 수신자 결정과 전달 작업 생성 | 메시지 순서를 다시 정하는 일 |
| Inbox 저장소 | 사용자별 메시지 포인터와 전달 상태 | 본문 장기 보관 |
| Push Worker | 오프라인 단말에 알림 시도 | 본문과 복구 원본 보관 |
| Presence Store | 만료되는 접속 상태 | 정확한 로그인 감사 기록 |
예를 들어 Fanout Worker가 순서를 다시 정하기 시작하면 순서를 정하는 곳이 두 군데가 되어 I2가 깨집니다. Push Worker에 본문을 맡기면 외부 푸시 공급자의 장애가 메시지 유실로 이어집니다.
메시지를 언제 수락된 것으로 보는가
책이 비워 둔 첫 번째 빈칸, 곧 송신자 화면의 메시지 옆에 "전송됨"을 띄우는 시점입니다. 저는 메시지 상태를 다섯 가지로 나눴습니다(원문 밖 확장).

그림에서 볼 것은 ACCEPTED와 DELIVERED가 다른 상태라는 점입니다. ACCEPTED는 서버가 잃지 않겠다고 약속한 상태이고, 상대 단말에 도착했다는 뜻이 아닙니다.
| 상태 | 뜻 | 주의할 점 |
| PENDING | 단말에는 있지만 서버 수락이 확정되지 않음 | 연결이 끊기면 같은 ID로 재시도 |
| ACCEPTED | 복제 로그에 기록되어 복구할 수 있음 | 상대 단말에 도착했다는 뜻은 아님 |
| DELIVERED | 수신자의 단말 하나 이상이 수신 확인 | 모든 단말 수신과는 다름 |
| READ | 수신자의 읽음 위치가 이 메시지 이상 | 제품 정책에 따라 끌 수 있음 |
| FAILED | 권한, 크기 제한처럼 다시 해도 안 되는 오류 | 일시 장애와 오류 코드를 구분 |
DELIVERED를 "단말 하나가 받았다"로 볼지 "켜져 있는 모든 단말이 받았다"로 볼지에 따라 상태 모델과 저장 비용이 달라집니다. 이 설계는 단말 하나 이상을 기본값으로 두었습니다. 서버가 소켓에 썼다는 것만으로는 DELIVERED로 보지 않습니다. 터널에 들어간 단말처럼 연결이 반쯤 열린 채 죽어 있으면, 서버가 쓴 데이터는 커널 송신 버퍼에 쌓였다가 한참 뒤에야 오류가 나기 때문입니다.
로그를 먼저 쓰는 방식. 저는 ACCEPTED를 메시지 저장소에 쓴 시점이 아니라, 여러 노드에 복제되는 로그에 기록이 확정된 시점으로 정했습니다. 로그는 도착한 순서대로 기록을 뒤에 덧붙이기만 하는 저장소이고, 복제 로그는 그 기록을 여러 노드에 복제해 한 노드가 죽어도 남게 한 것입니다. 로그에 먼저 쓰고 나머지를 뒤에서 처리하는 이 방식을 설계 문서에서는 log-first라고 불렀습니다.
"기록이 확정됐다"는 뜻은 복제본 수로 정했습니다. 복제본 3개 중 2개가 기록을 확인해야 수락합니다(설계 가정). 아래 그림은 한 메시지가 수락되기까지의 순서입니다.
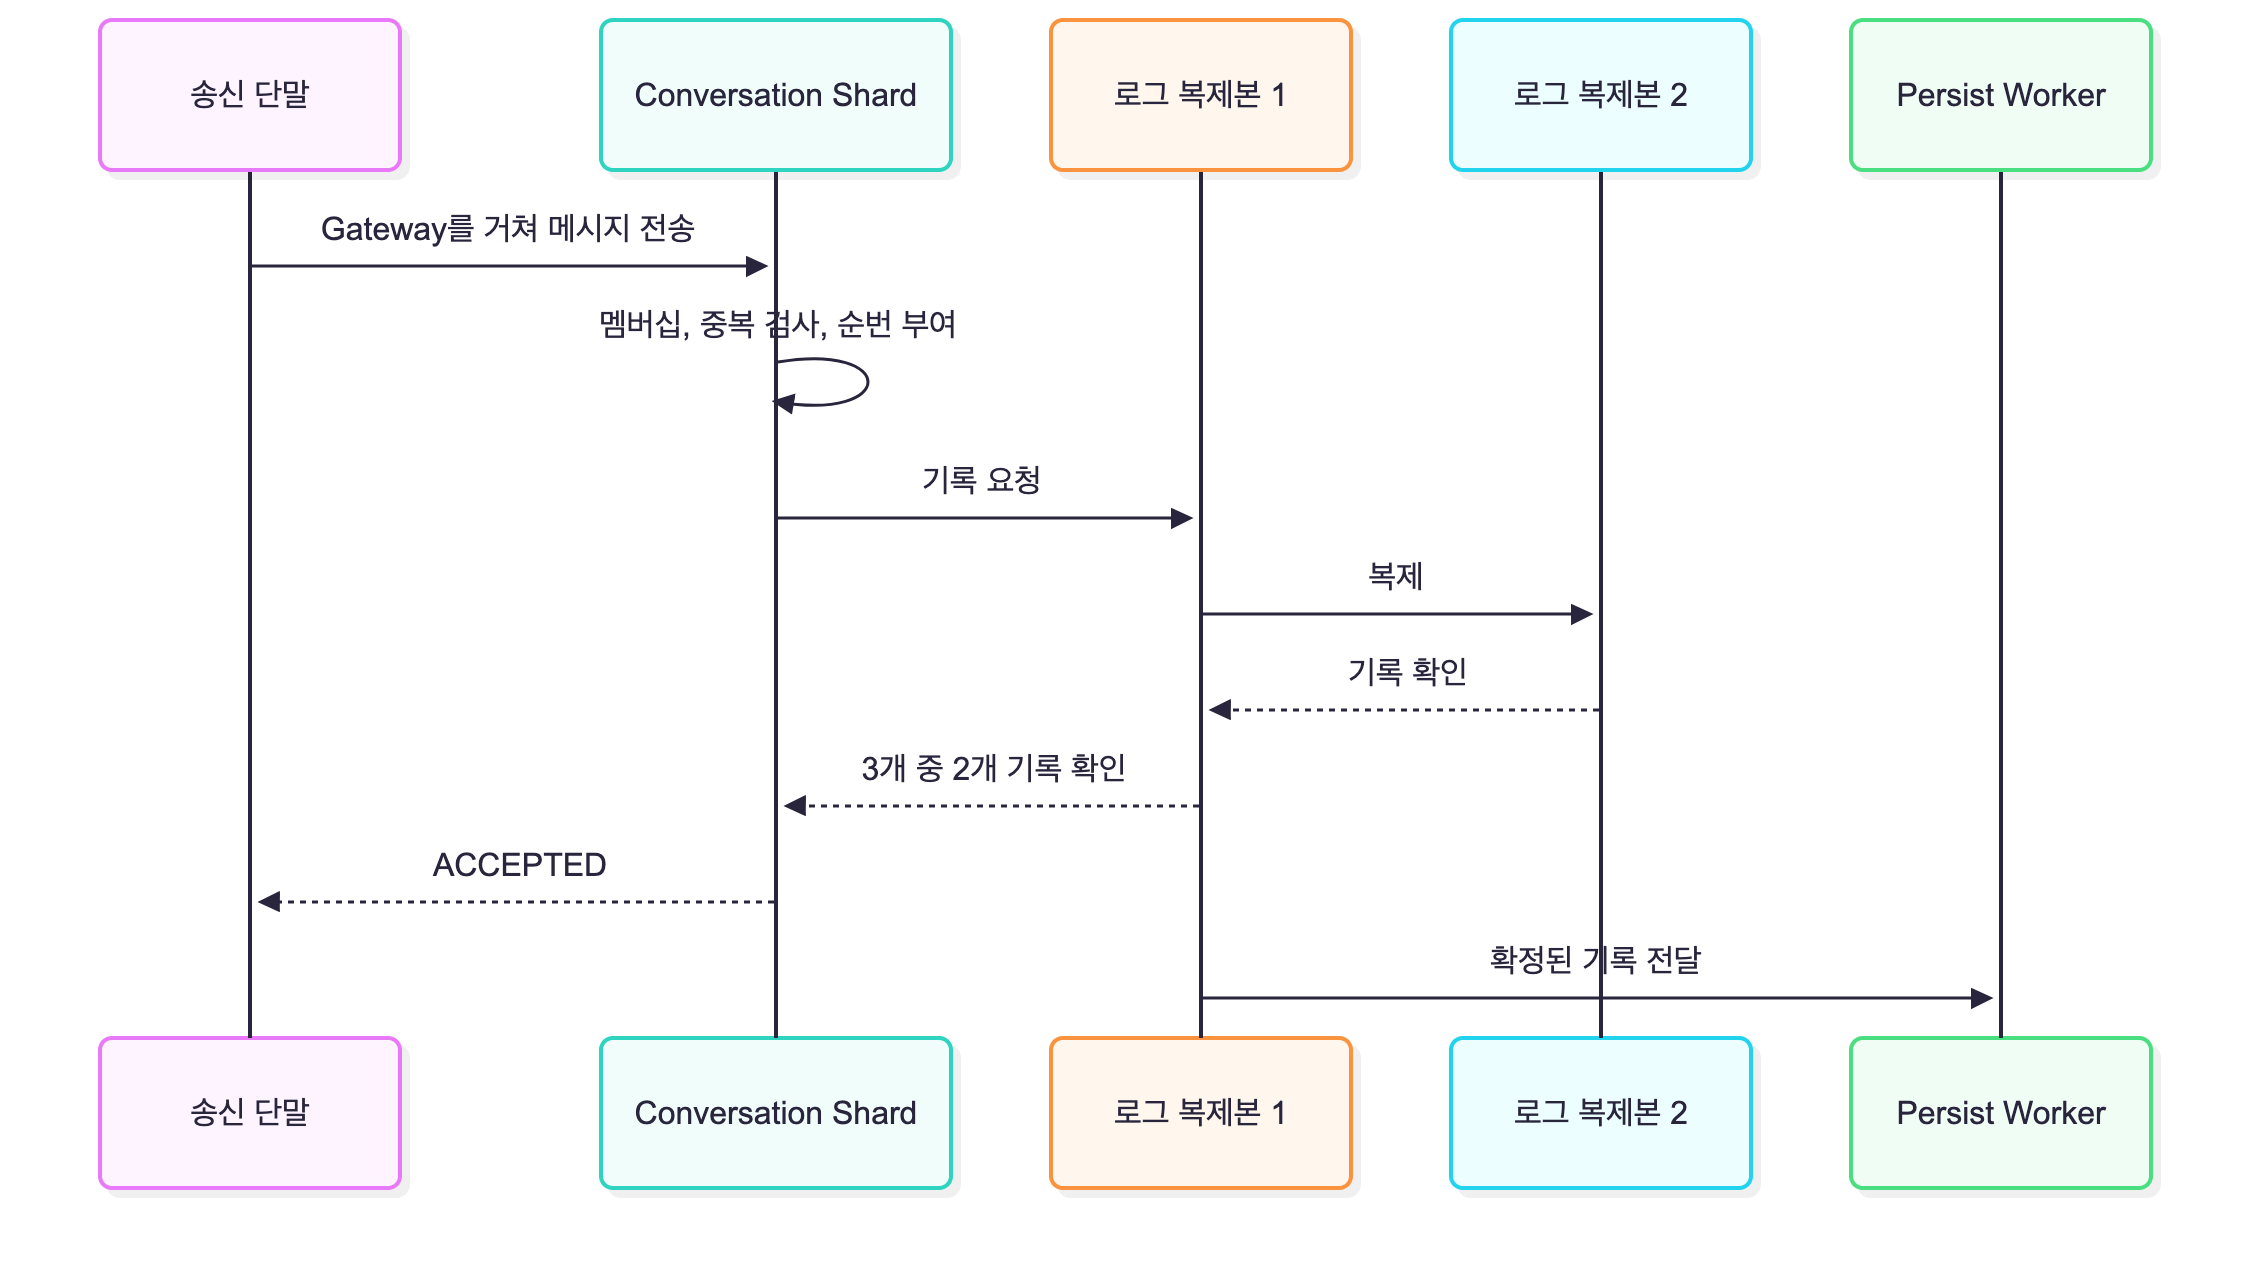
그림에서 볼 것은 ACCEPTED가 복제 확인 뒤에만 나간다는 점과, 저장소 저장(Persist Worker)은 그 뒤에 따로 일어난다는 점입니다. 아래 Java는 Shard의 수락 경로를 보여 주는 서비스 로직 예시입니다. idempotency, log, sequences는 도메인 인터페이스이며, 실제 저장소 구현은 생략했습니다.
Accepted send(SendCommand cmd) {
    // 최근 키가 없으면 확정 로그나 Message Store에서도 기존 결과를 확인한다.
    var previous = idempotency.findResult(cmd.senderUserId(), cmd.clientMessageId());
    if (previous.isPresent()) {
        return previous.get(); // 응답이 유실된 요청의 재시도
    }

    checkMembership(cmd.conversationId(), cmd.senderUserId());
    long seq = sequences.next(cmd.conversationId());
    String messageId = messageIds.next();
    var event = new MessageEvent(cmd, messageId, seq);

    log.appendAndWaitForQuorum(event); // 복제본 3개 중 2개 확인. 실패하면 예외를 돌려준다.
    var accepted = new Accepted(cmd.clientMessageId(), messageId, seq);
    idempotency.remember(cmd.senderUserId(), cmd.clientMessageId(), accepted);
    return accepted; // 로그 기록이 확정된 뒤에만 송신자에게 보낸다.
}
- 근거: I1입니다. 복제본 두 곳에 있으면 그중 한 곳이 죽어도 나머지에서 복구할 수 있습니다. 로그는 끝에 덧붙이는 쓰기라서 여러 행을 묶는 트랜잭션보다 단순하고, 저장소가 잠시 느려져도 로그가 완충 역할을 해서 수락은 계속됩니다. 로그를 읽어 처리하는 작업자가 재시작해도 로그에서 다시 읽으면 되고, 검색 색인이나 감사 로그처럼 나중에 붙는 처리도 로그를 따로 읽어 늘릴 수 있습니다.
- 트레이드오프: 수락 경로에서 저장소를 빼는 대신, 성공 응답 직후 저장소를 조회하면 잠시 메시지가 안 보일 수 있습니다. 저장이 얼마나 밀렸는지를 늘 관측해야 하고, 로그에 쌓인 이벤트의 형식이 바뀔 때 옛 형식과 호환되게 해야 합니다. 송신 단말은 보낸 메시지를 먼저 화면에 그려 두고 서버 응답이 오면 단말이 만든 ID로 합쳐서, 같은 단말에서는 이 지연을 가립니다.
- 장애: 살아 있는 복제본이 2개 미만으로 줄면 그 로그 구간은 쓰기를 거부합니다. 그 구간에 속한 대화의 송신은 재시도 가능한 오류로 돌아가고, 사용자에게는 "전송 중" 표시가 오래 남는 것으로 보입니다. 잃는 대신 멈추는 쪽, 곧 가용성을 내주고 내구성을 지키는 선택입니다.
- 반례: 복제본 한 곳의 기록만 확인하고 수락하면 수락은 더 빨라지지만, 그 노드가 다른 복제본에 넘기기 전에 죽으면 ACCEPTED를 받은 메시지가 어디에도 없습니다. 송신자는 이미 성공 응답을 받았으므로 재시도하지 않고, 오류도 나지 않으니 조용히 사라집니다. I1을 지키지 못하므로 메시지 본문에는 쓸 수 없고, 다음 값이 덮어쓰는 입력 중 표시 같은 이벤트에만 맞습니다.
- 예상되는 문제점: 배포 중 노드를 차례로 재시작할 때마다 복제본 수가 잠시 줄어, 다른 장애와 겹치면 수락이 거부됩니다. 복제본 노드 하나가 어느 순간 빠져 있을 확률을 p라 하고 서로 독립이라 두면, 쓰기가 거부될 확률은 두 곳 이상이 빠질 확률인 3p²(1 - p) + p³입니다. p = 0.01이면 약 0.0003입니다. 실제로는 같은 AZ의 노드가 함께 빠지고 재시작이 겹치므로 이 값은 하한에 가깝고, 로그 구간이 수천 개면 "어느 한 구간이라도 거부 중"일 확률은 훨씬 큽니다.
데이터베이스를 먼저 쓰는 대안. 규모가 작거나, 쓰자마자 읽었을 때 반드시 보여야 한다면 데이터베이스 한 트랜잭션에 메시지와 "보낼 이벤트" 행을 함께 기록하고, commit 뒤에 성공 응답을 보내는 방식을 쓸 수 있습니다. 보낼 이벤트 행은 별도 작업자가 읽어 전달 과정으로 넘깁니다. 이 방식을 Transactional Outbox라고 부릅니다.
BEGIN;
UPDATE conversations SET last_seq = last_seq + 1
 WHERE conversation_id = :cid RETURNING last_seq;        -- 대화 단위로 순번
INSERT INTO messages (conversation_id, conversation_seq, message_id,
                      sender_user_id, client_message_id, body)
VALUES (:cid, :seq, :mid, :uid, :cmid, :body);            -- (uid, cmid) 유일성으로 멱등
INSERT INTO outbox (id, aggregate_id, payload, created_at)
VALUES (:oid, :cid, :event_json, now());
COMMIT;                                                   -- 이 뒤에 ACCEPTED
조회 일관성이 단순해지는 대신 데이터베이스가 수락과 이벤트 생산 양쪽의 병목이 됩니다. 피크 231,480건/초면 트랜잭션마다 메시지 행과 이벤트 행을 쓰므로 초당 약 46만 행이고, 작업자가 발행 표시를 하면 초당 약 69만 쓰기가 됩니다. 반대로 로그 우선은 수락 경로에 로그 기록 한 번만 넣고, 초당 231,480건의 저장소 쓰기는 뒤에서 합니다.
저는 쓰기량이 많고 뒤에서 처리할 작업이 여러 개라는 이유로 로그를 먼저 쓰는 쪽을 골랐습니다. 다만 초기 서비스라면 데이터베이스를 먼저 쓰는 쪽이 운영하기 더 쉬울 수 있습니다. 하루 메시지가 수십만 건이고 로그를 읽는 작업자가 하나뿐이라면 로그 노드 세 대를 따로 운영하는 비용이 얻는 것보다 큽니다. 설계 문서에도 "규모가 크다는 이유만으로 처음부터 컴포넌트를 모두 분리하지 않는다"고 적었고, 구현 순서도 처음에는 Gateway와 메시지 API, 저장소 하나로 시작해 처리량과 장애 격리가 필요해질 때 Shard를 떼어 내고 복제 로그를 들이는 식으로 나눴습니다.
ID 세 개와 멱등 처리
수락 시점을 정하고 나면 바로 다음 문제가 생깁니다. 서버가 로그 기록을 마친 직후 성공 응답이 네트워크에서 사라지면, 클라이언트는 같은 메시지를 다시 보냅니다. 이 재시도를 알아보려면 메시지를 가리키는 ID가 필요합니다.
책에서는 message_id 하나가 메시지를 구별하는 일과 순서를 나타내는 일을 함께 맡습니다(원문). 책은 created_at으로 순서를 정할 수 없는 이유로 두 메시지가 동시에 만들어질 수 있다는 점을 들고, ID 생성 방법으로 RDBMS의 auto_increment, 스노플레이크 같은 전역 64비트 순서 번호 생성기, 같은 대화 안에서만 유일하면 되는 지역 순서 번호 생성기를 소개합니다(원문). 저는 이 책임을 세 ID로 나눴습니다(원문 밖 확장).
| 식별자 | 만드는 곳 | 하는 일 |
| client_message_id | 송신 단말 | 네트워크 재시도에서 같은 메시지임을 알아보게 함 |
| message_id | 서버 | 시스템 전체에서 메시지 하나를 가리킴 |
| conversation_seq | Conversation Shard | 한 대화 안에서 보여 주고 동기화하는 순서 |
client_message_id는 단말이 재시도할 때 바꾸지 않습니다. 네트워크 요청 한 번을 추적하는 request_id와는 따로 둡니다. 요청은 여러 번 나갈 수 있어도 논리적인 메시지는 하나이기 때문입니다. 이렇게 나누면 전역에서 유일한 ID를 만들려고 모든 대화를 한 줄로 세울 필요가 없습니다. 사용자에게 필요한 순서는 대부분 같은 대화 안의 순서입니다. 순서를 붙이는 방법은 다음 편에서 다룹니다.
멱등 처리. 같은 요청을 여러 번 보내도 결과가 한 번 보낸 것과 같게 만드는 것을 멱등 처리라고 합니다. 멱등 키는 (sender_user_id, client_message_id)로 두고, 다섯 곳에서 중복을 막았습니다. 곳마다 막는 중복의 원인이 다르기 때문입니다.
| 거르는 곳 | 키 | 막는 중복의 원인 |
| Conversation Shard | (sender_user_id, client_message_id) | 단말의 재시도 |
| Message Store | (conversation_id, bucket, conversation_seq) 유일 키; 오래된 재시도 조회에는 (sender_id, client_message_id) 색인 | 같은 로그 이벤트를 다시 저장하지 않음; 최근 키가 만료된 요청의 기존 결과 조회 |
| Fanout 작업 | (recipient_id, message_id) | Fanout 작업자의 재처리 |
| 수신 단말 | message_id 또는 conversation_seq | 실시간 전달과 재접속 동기화로 같은 메시지를 두 번 받음 |
| 송신 단말 | client_message_id | 화면에 먼저 그린 메시지와 서버 응답을 합침 |
Shard는 처음 보는 키면 message_id와 conversation_seq를 붙이고 로그에 기록하고, 이미 처리한 키면 새 번호를 매기지 않고 저장된 결과를 그대로 돌려줍니다. Persist Worker는 같은 이벤트를 두 번 읽어도 한 행만 남도록 조건부로 씁니다.
INSERT INTO messages (conversation_id, bucket, conversation_seq, message_id, sender_id, client_message_id, body)
VALUES (...)
ON CONFLICT (conversation_id, bucket, conversation_seq) DO NOTHING;   -- 같은 로그 이벤트를 두 번 소비해도 한 행
예시는 PostgreSQL 문법이고, 실제 Message Store 후보의 문법은 제품마다 다릅니다. 저장소가 wide-column 계열이라면 "없을 때만 넣기"가 합의 과정을 거쳐 비싸질 수 있습니다. 이 경우 같은 (conversation_id, bucket, conversation_seq)에 같은 내용을 다시 쓰는 방식도 비교할 수 있습니다. 어느 방식을 쓰든 충돌이 나면 기존 행의 message_id와 새 이벤트의 값을 비교해, 같은 순번에 서로 다른 메시지가 들어오는 오류를 감지해야 합니다. 이 유일 키는 저장 작업자의 재처리를 막고, 최근 키가 만료된 송신 요청의 중복 여부는 별도의 (sender_id, client_message_id) 조회로 확인합니다.
최근 키를 얼마나 들고 있을까. 최근 키는 단말의 자동 재시도 기간보다 길게 보관해야 합니다. 자동 재시도 기간을 10분, 항목 하나(키, message_id, 순번, 만료 시각)를 64바이트로 가정하면(설계 가정) 다음과 같습니다.
평균 23,148건/초 × 600초 ≈ 1,389만 개 × 64B ≈ 약 0.9GB
피크 231,480건/초 × 600초 ≈ 1억 3,889만 개 × 64B ≈ 약 8.9GB
여러 Shard에 나눠 들고 있으면 메모리에 충분히 올릴 수 있는 크기입니다. 재시도 기간을 1분으로 줄이면 피크 기준 약 0.9GB로 줄지만, 지하철 터널처럼 몇 분 끊기는 흔한 경우의 재시도가 모두 저장소 조회로 넘어갑니다. 1시간으로 늘리면 약 53GB가 되어 Shard 메모리에 부담이 됩니다. 키를 26자 문자열로 저장하거나 본문 해시를 함께 두면 항목이 100바이트 가까이 되어 피크 약 13.9GB입니다. 재시도 기간은 단말의 재시도 정책과 재접속까지 걸린 시간의 p99를 보고 정하고, 항목 크기는 실제 자료구조에 항목을 넣어 메모리 증가분을 재서 정합니다.
최근 키만 믿지 않은 이유는 키가 만료되거나 장애로 날아간 뒤에 재시도가 들어올 수 있어서입니다. 그 기간이 지난 재요청은 Message Store의 (sender_id, client_message_id) 색인에서 기존 결과를 찾고, 재시도 계약의 유효 기간까지 지났다면 만료 오류로 처리합니다. 아직 로그에만 있고 저장소에 반영되지 않은 메시지도 있으므로, 저장소에 없다는 이유만으로 새 메시지라고 단정해서는 안 됩니다. 위의 10분은 최근 키 메모리를 계산하기 위한 가정이고, 재시도 계약의 만료 시각은 별도로 정해야 합니다. 보관 기간을 끝없이 늘리는 대신 이 조회와 만료 정책을 명시하는 쪽을 택했습니다.
"정확히 한 번"을 약속하지 않은 이유. 응답이 사라진 클라이언트는 성공했는지 알 방법이 없으니 다시 보내야 합니다. 서로 메시지를 주고받는 두 쪽이 "상대가 확실히 받았다"는 사실에 끝까지 합의할 수 없다는 이 문제를 두 장군 문제라고 부릅니다. 그래서 내부 전달은 적어도 한 번(at-least-once) 일어나게 하고, 여러 곳의 멱등 처리로 사용자 화면에는 한 번만 보이게 했습니다. "정확히 한 번"이라는 말 대신 다음처럼 확인할 수 있는 계약으로 적었습니다.
- 성공 응답 이후 메시지는 사라지지 않는다.
- 계약한 재시도 기간 안에 같은 client_message_id로 다시 보내면 같은 결과가 돌아온다. 기간이 지나면 기존 결과를 조회하거나 만료 오류를 준다.
- 중복 이벤트가 와도 화면에는 한 번만 보인다.
- 같은 대화의 참여자는 결국 같은 순서를 본다.
저장이 끝난 뒤에 전달하는 순서
책이 비워 둔 두 번째 빈칸은 저장과 전달의 선후였습니다. 공부하면서 판단이 실제로 바뀐 곳이 여기입니다.
처음 쓴 설계 문서(1차 판)에서는 로그에서 Message Store 저장과 Fanout Worker가 동시에 이벤트를 읽었습니다. 장점으로 "fanout, 검색 색인, 감사 로그가 같은 원본 이벤트를 독립적으로 구독할 수 있다"를 적었고, Message Store 장애의 영향은 "ACK 후 조회 지연 증가"로만 적었습니다. 1차 판의 구조 그림에는 Inbox 저장소도 따로 없어서, Fanout Worker가 연결 위치를 찾아 바로 Gateway나 푸시로 넘겼습니다. 최신판에서는 이것을 "저장 성공 뒤 전달"로 바꿨습니다. 두 판의 차이를 나란히 그리면 다음과 같습니다.
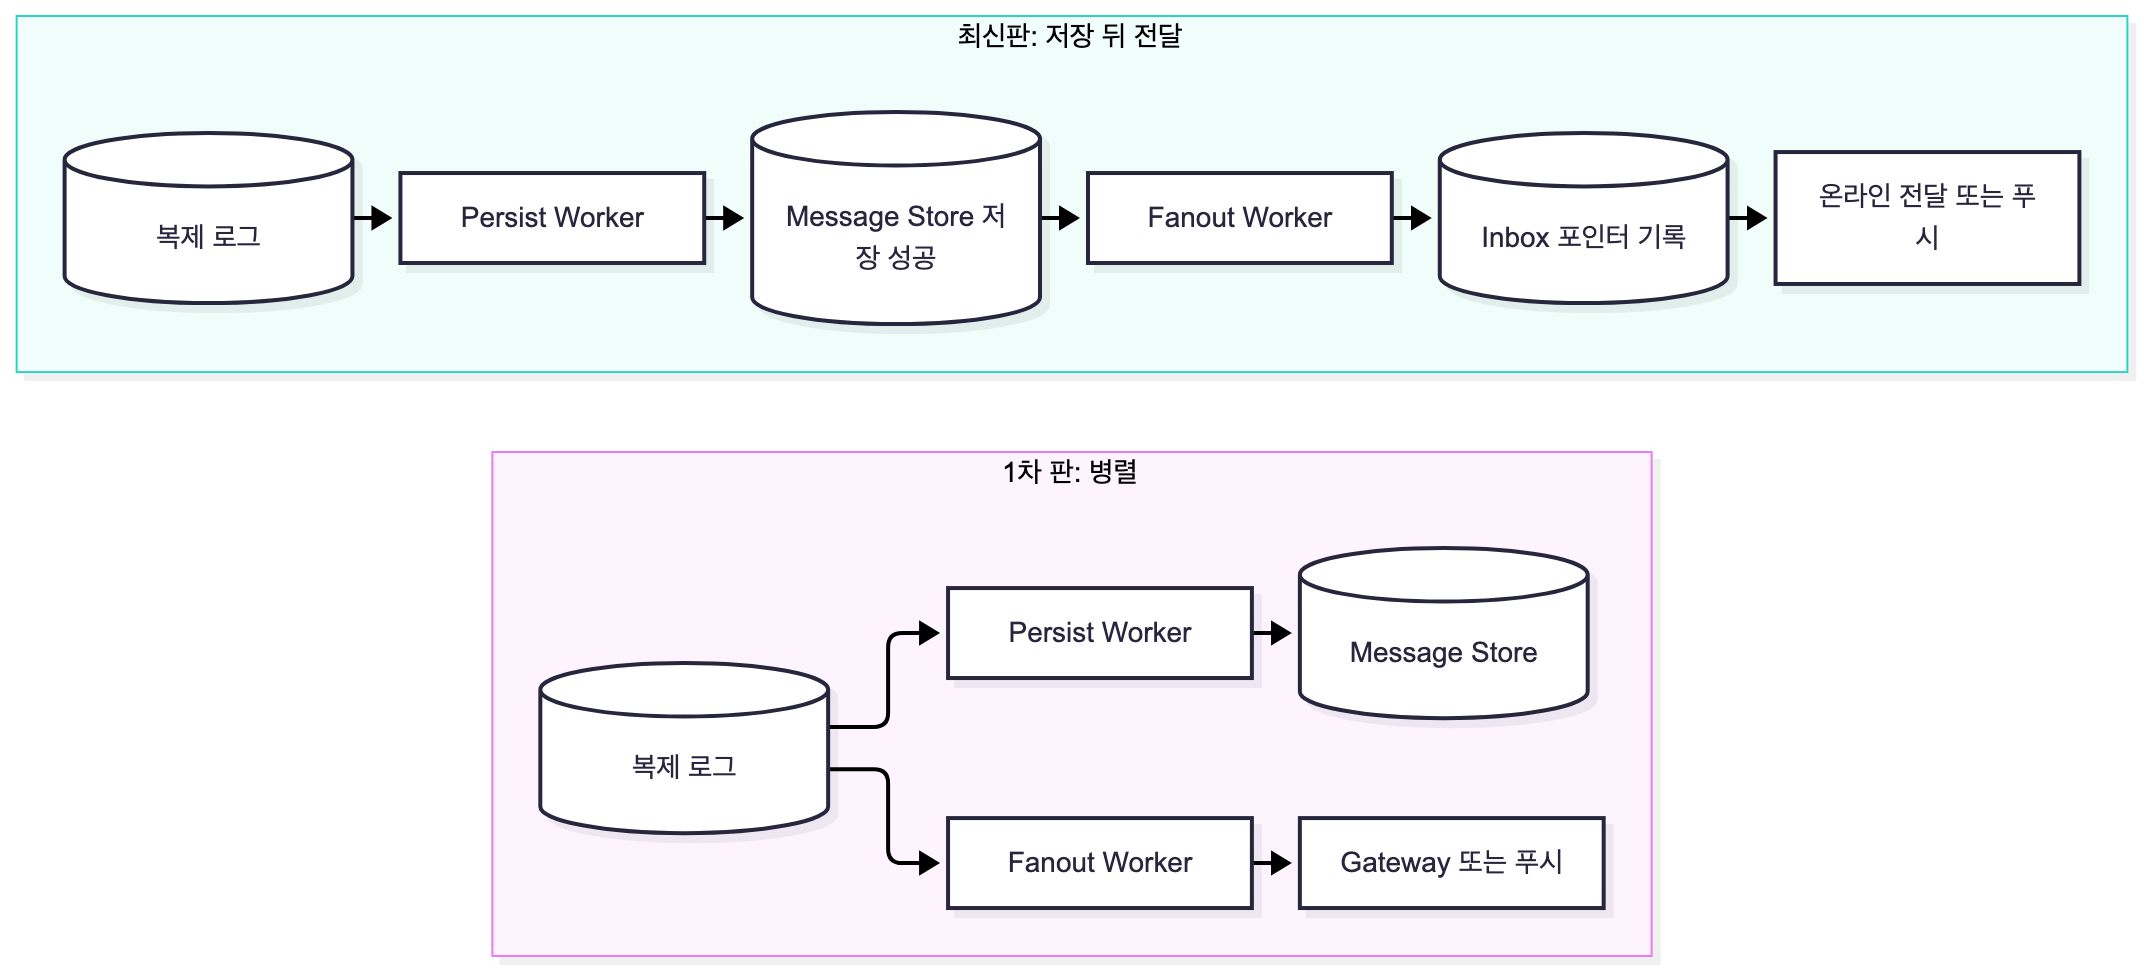
그림에서 볼 것은 최신판에서 전달이 두 번의 쓰기(Message Store 저장, Inbox 포인터 기록) 뒤에 온다는 점입니다. Message Store에서 Fanout Worker로 가는 화살표는 데이터베이스가 작업자를 부른다는 뜻이 아니라, Persist Worker가 저장 성공을 확인한 뒤에 fanout 작업을 내보낸다는 선후 관계입니다.
바꾼 이유로 적은 것은 전달된 메시지는 반드시 다시 조회할 수 있어야 한다는 성질입니다. 병렬로 두면 저장보다 전달이 먼저 끝날 수 있고, 그 사이에 저장소 쓰기가 실패하면 상대 단말은 메시지를 봤는데 재접속한 뒤 이력에서는 찾을 수 없는 상태가 생깁니다. 저장 뒤로 전달을 미루면 이 상태가 생기지 않습니다.
저장 작업자의 실제 처리 순서는 Java로 쓰면 다음과 같습니다. insertIfAbsent는 앞서 정한 (conversation_id, bucket, conversation_seq) 키로 중복을 막고, 같은 키에 다른 message_id가 있으면 오류를 냅니다. publishOnce도 같은 이벤트를 재처리해도 전달 작업이 하나만 남게 해야 합니다.
void persist(MessageEvent event) {
    store.insertIfAbsent(event);      // 본문 저장이 성공하거나 같은 이벤트가 이미 있어야 다음 단계로 간다.
    fanout.publishOnce(event);        // 저장 전에는 수신자 전달 작업을 만들지 않는다.
    log.markDone(event);              // 여기서 실패하면 재처리하며, 위 두 작업은 멱등하다.
}
대신 치르는 비용. Message Store가 장애 나면 새 메시지의 실시간 전달까지 멈춥니다. 저장 쓰기 지연도 온라인 전달 지연에 그대로 더해집니다. 온라인 전달 목표를 p99 1초로 두었는데(설계 가정), 저장 쓰기 p99가 800ms로 늘어나면 나머지 단계에 남는 것은 200ms뿐입니다. 그래서 수락에서 저장까지와 저장에서 전달까지의 지연을 따로 잽니다. 트레이드오프 표에는 병렬 방식을 "지연이 가장 중요하고 별도 전달 버퍼를 감당할 수 있을 때" 고를 수 있는 다른 선택으로 남겼습니다.
로그 보존 기간이 복구 계약이 됩니다. Store 장애 중에도 이미 수락한 메시지는 로그에 남아 있으므로 복구 뒤에 다시 처리하면 됩니다. 다만 로그가 저장 전 메시지의 유일한 원본인 동안에는, 로그가 그 기록을 지우기 전에 저장을 끝내야 합니다. 그래서 보존 기간을 이렇게 잡았습니다.
로그 보존 기간 > 최대 장애 복구 시간 + 최대 저장 지연 + 클라이언트 재시도 보장 기간
              = 6시간 + 1시간 + 24시간 = 31시간   (세 값 모두 설계 가정)
31시간 동안 피크 유입이 계속된다고 보면 약 25.8TB(231.48MB/초 × 111,600초), 평균 유입이면 약 2.6TB이고, 복제본 3개를 곱하면 각각 약 77.5TB와 약 7.8TB입니다. 설계 문서 본문에서는 같은 식에 최대 장애 복구 24시간, 최대 저장 지연 2시간을 넣어 50시간을 예로 들었습니다. 두 값의 차이는 대부분 최대 장애 복구 시간을 24시간으로 보느냐 6시간으로 보느냐에서 옵니다. 50시간이면 평균 유입 기준 복제 전 약 4.2TB, 복제 후 약 12.5TB입니다. 이 숫자가 틀리는 경우는 양쪽에 있습니다.
- Store 복구가 6시간이 아니라 10시간 걸리면 필요한 보존 기간은 35시간입니다. 보존을 31시간으로 고정해 두었다면, 장애 시작 무렵 수락했지만 아직 저장하지 못한 메시지 가운데 4시간 분량이 저장 전에 로그에서 지워집니다. 이것이 I1 위반입니다.
- 보존을 시간이 아니라 크기로 제한하는 로그라면, 크기 한도를 평균 유입으로 계산해 둔 경우 피크가 이어지면 훨씬 일찍 지워집니다. 평균 기준 31시간 분량(약 2.6TB)은 피크 10배 유입으로 약 3.1시간이면 찹니다.
- 반대로 7일로 넉넉히 잡으면 평균 유입 기준으로 복제 전 약 14TB, 복제 후 약 42TB를 늘 들고 있어야 합니다. 31시간의 약 5.4배입니다.
그래서 보존 기간을 숫자 하나로 믿지 않고, 저장이 밀린 양이 남은 보존 시간을 넘기기 전에 수락을 제한하는 규칙을 함께 두었습니다. 유실 대신 수락 거부를 택하는 것이고, 사용자에게는 오류가 보이지만 메시지는 잃지 않습니다.
아래는 이 판단을 수행하는 Java 서비스 로직의 핵심입니다. 시간 값은 모두 초 단위이고, 저장 처리율이 0이면 소진 시간은 무한대로 취급합니다.
void controlAdmission(double retentionSeconds, double oldestUnpersistedAgeSeconds,
                      long backlogEvents, double persistRatePerSecond) {
    double margin = retentionSeconds - oldestUnpersistedAgeSeconds;
    double drainTime = backlogEvents == 0 ? 0
            : persistRatePerSecond <= 0 ? Double.POSITIVE_INFINITY
            : backlogEvents / persistRatePerSecond;

    if (margin < drainTime + safetySeconds) {
        admission.rejectRetryable("server busy");
    } else if (margin < warnThresholdSeconds) {
        admission.rateLimitSends();
    }
}
장애 중에는 저장 처리율이 0이라 소진 시간이 무한대로 나오므로, "장애가 풀리면 제한을 푼다"가 아니라 소진 시간이 남은 여유보다 짧아질 때까지 제한을 유지합니다.
그룹 전달은 쓰기 시점에 복사합니다. 책은 메시지를 수신자마다 있는 메시지 동기화 큐에 복사하는 방식을 설명하고, 이 방식이 소규모 그룹에 맞는 이유로 각자 자기 큐만 보면 된다는 점과 그룹이 작으면 복사 비용이 문제되지 않는다는 점을 듭니다(원문). 책의 그룹 상한이 100명이므로 저도 메시지가 저장될 때 수신자마다 전달 작업을 만드는 방식(fanout-on-write)을 골랐습니다. 이때 처리량은 메시지 수가 아니라 수신자 수의 합으로 계산해야 합니다.
전달 작업 QPS = Σ(메시지 1건의 실제 수신자 수)
| 경우 | 1건당 수신자 | 전달 작업/초 |
| 전부 1:1 | 1 | 231,480 |
| 1:1 70%, 평균 20명 그룹 30%(설계 가정) | 0.7 × 1 + 0.3 × 19 = 6.4 | 약 1,481,472 |
| 전부 100명 그룹(극단) | 99 | 약 22,916,520 |
전달 작업은 메시지 유입의 1배에서 99배 사이에 놓이고, 그 배수를 정하는 것은 트래픽 구성입니다. 1:1과 그룹의 비율, 그룹의 평균 활성 인원을 측정해야 전달 작업자 수가 정해집니다. 이 선택이 틀리는 입력은 수만 명짜리 방입니다. Discord는 2017년 글에서 동시 접속 3만 명인 서버에서 이벤트 하나를 퍼뜨리는 데 900ms에서 2.1초가 걸렸다고 밝혔습니다. 책의 100명 상한 안에서는 해당하지 않지만, 대형 채널을 요구사항에 넣으면 전달 방식부터 다시 정해야 합니다.
Inbox에는 본문이 아니라 포인터를 둡니다. 수신자마다 본문 전체를 복사하면 100명 그룹의 메시지 하나가 본문 99벌이 됩니다. 그래서 Inbox에는 (recipient_user_id, inbox_event_id, conversation_id, conversation_seq, message_id, delivery_status)만 기록하고 본문은 Message Store에서 읽습니다. 평균 수신자 6.4명이면 하루 수신함 항목이 128억 개인데, 본문(평균 1KB)까지 복사하면 하루 약 12.8TB, 포인터(100B, 설계 가정)만 두면 약 1.28TB입니다. 본문 복사는 원본 저장량(하루 약 2TB)의 여섯 배가 넘습니다. 대신 재접속 때 본문을 Message Store에서 한 번 더 묶어 읽어야 합니다.
inbox_event_id는 사용자마다 따로 증가하는 번호로, 단말이 "어디까지 받았는지"를 기억하는 기준이 됩니다. 서로 다른 대화 사이의 의미 있는 순서가 아니라, 단말이 빠진 것을 채우기 위한 사용자별 순서입니다. 포인터를 먼저 기록한 뒤에 전달하므로, 실시간 전달이 실패해도 단말은 다음 동기화 때 이 포인터를 다시 읽어 채울 수 있습니다. Inbox 쓰기도 (recipient_id, message_id)로 멱등하게 해서, Fanout 작업자가 99명 중 50번째에서 죽고 다시 시작해도 포인터는 99개 그대로입니다.
재접속 뒤 빠진 메시지를 채우는 방법
전달을 저장 뒤로 미루고 Inbox에 포인터를 남긴 것은 재접속을 위해서이기도 합니다. 책은 단말마다 cur_max_message_id라는 변수를 두고, 그 단말이 본 가장 큰 메시지 ID보다 큰 메시지를 저장소에서 가져오는 방식으로 여러 단말을 동기화합니다(원문). 저는 이것을 세 개의 위치 표시(cursor)로 나눴습니다(원문 밖 확장).
| cursor | 범위 | 용도 |
| last_received_seq | 단말, 대화 | 이 단말이 받은 마지막 메시지 |
| last_read_seq | 사용자, 대화 | 사용자가 읽은 마지막 메시지 |
| last_sync_event_id | 단말 전체 | 대화 목록, 멤버십, 메시지의 증분 동기화 위치 |
받은 것과 읽은 것은 다릅니다. 앱이 백그라운드에서 메시지를 받았어도 사용자는 아직 읽지 않았을 수 있습니다. last_sync_event_id는 앞 절의 inbox_event_id를 기준으로 하는 사용자별 위치이고, 시스템 전체의 전역 번호가 아닙니다. 공개 사례에서도 비슷한 모양이 보입니다. Facebook은 2014년 글에서 Messenger가 업데이트를 순서대로 쌓는 큐를 두고 앱에 보낸 위치를 가리키는 포인터를 따로 둔다고 설명합니다.
재접속 절차는 다음과 같습니다.
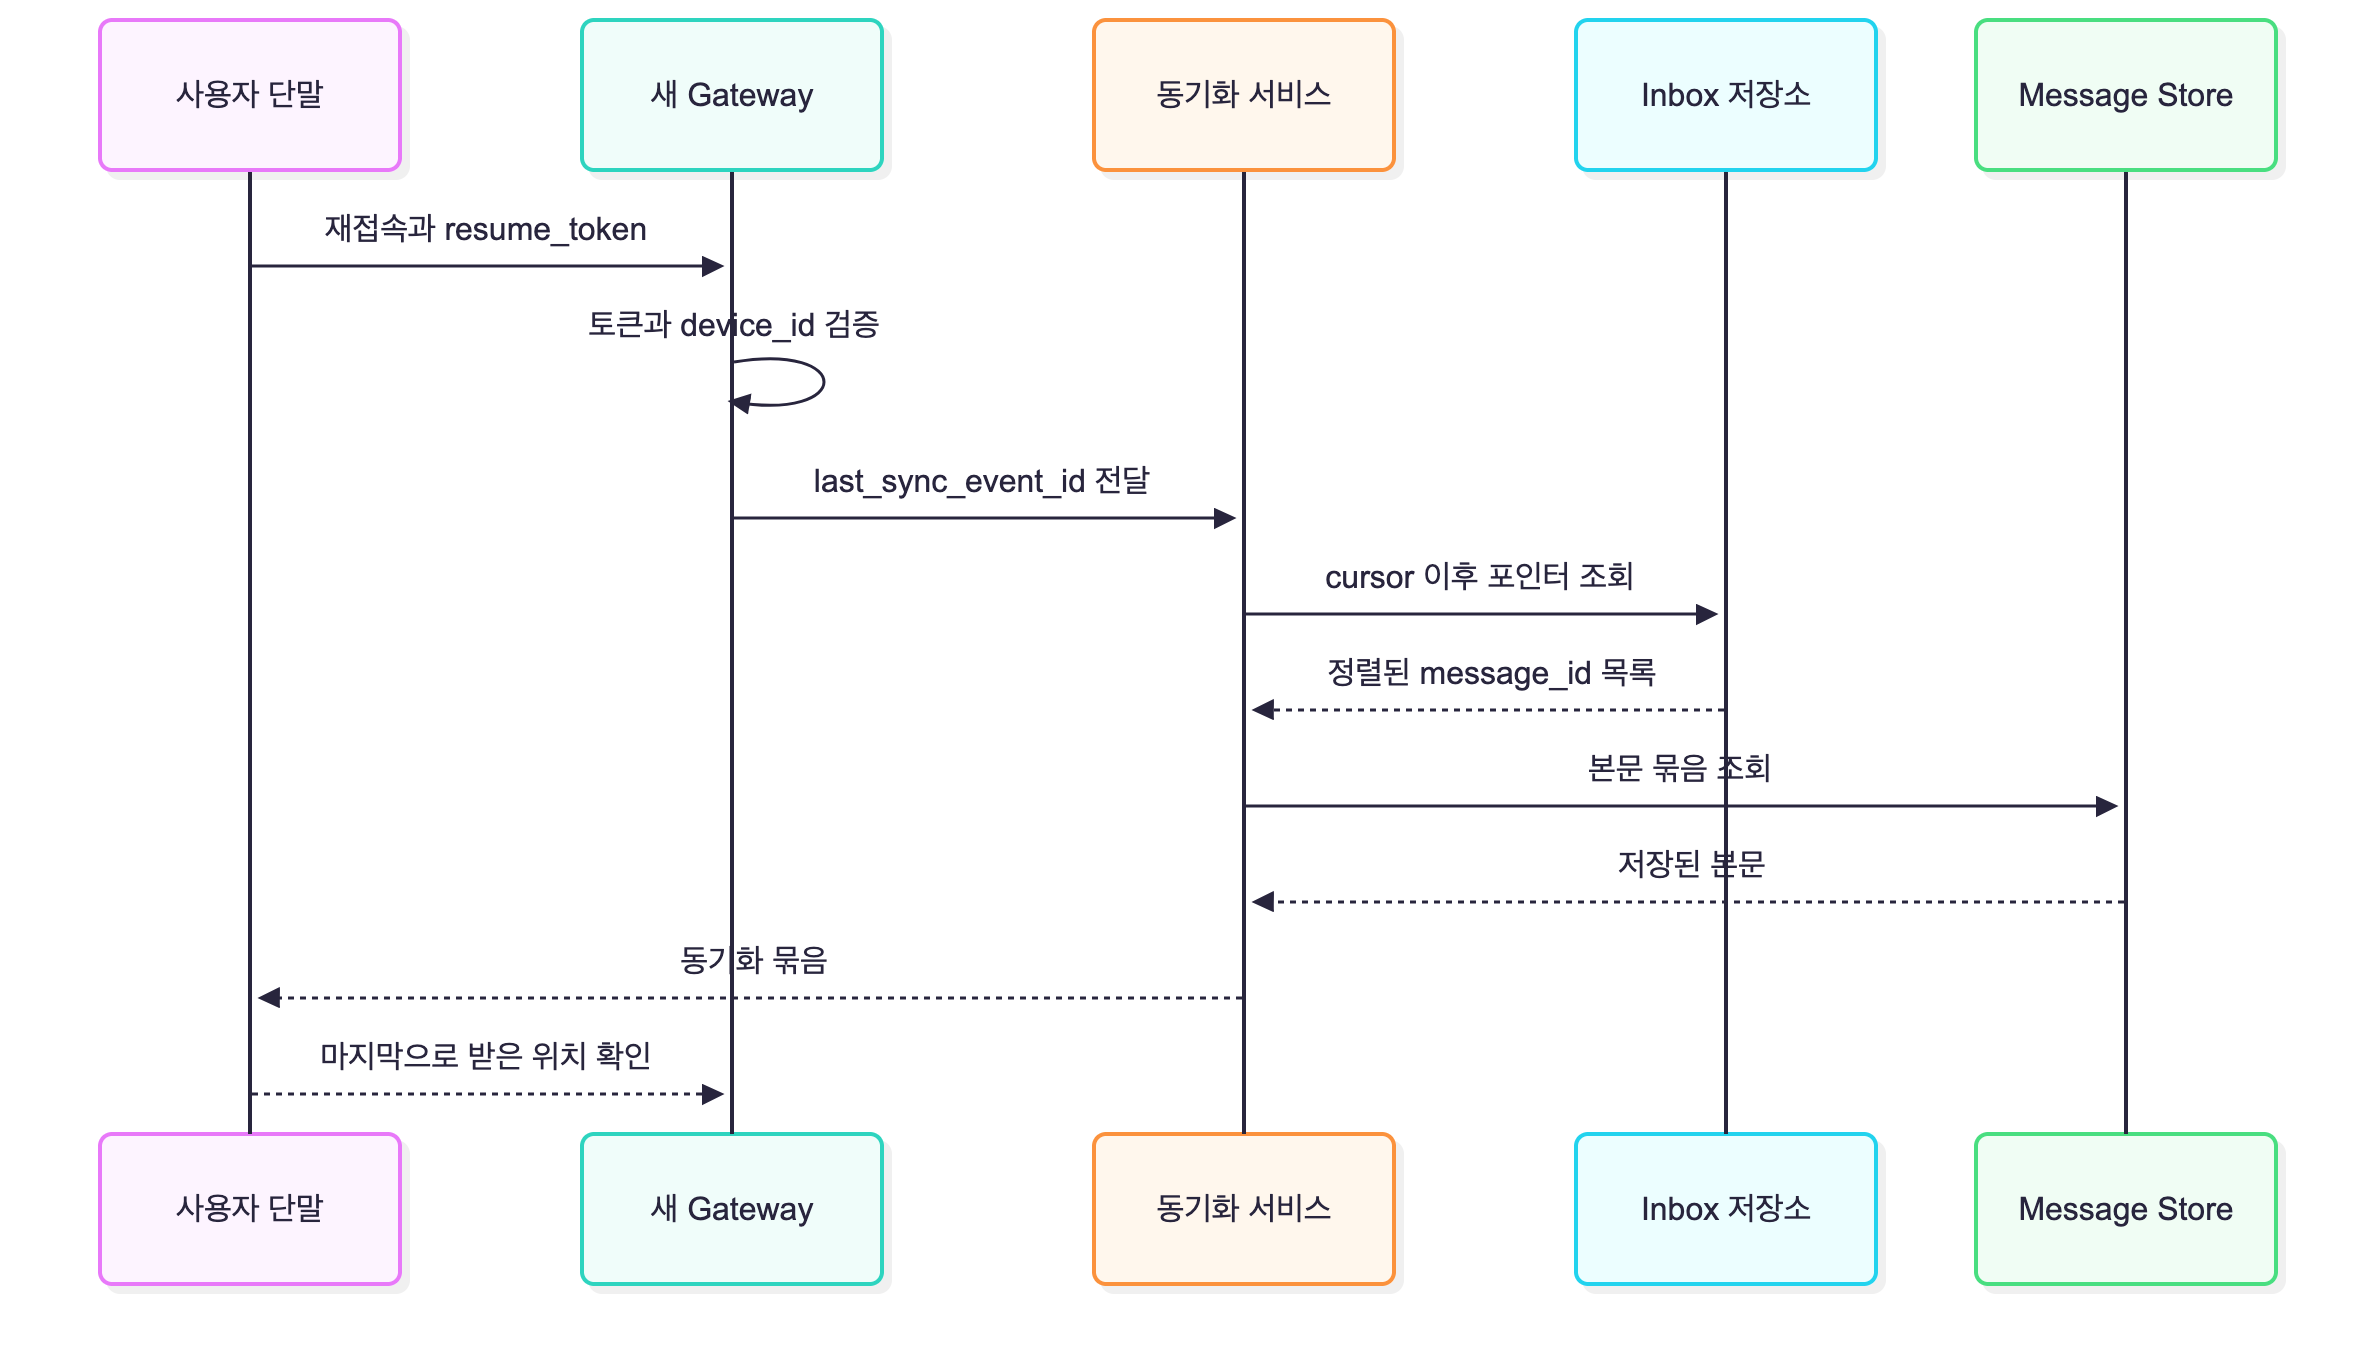
그림에서 볼 것은 새 Gateway가 이전 Gateway가 무엇을 들고 있었는지 몰라도 된다는 점입니다. 단말이 가진 위치 이후의 포인터를 Inbox에서 찾고 본문은 Message Store에서 가져오면 됩니다. Inbox에 포인터가 있는 메시지는 Message Store에 본문이 이미 있으므로, 앞 절에서 전달을 저장 뒤로 미룬 것이 여기서 쓰입니다. cursor는 단말이 받았다고 확인한 뒤에만 앞으로 옮깁니다.
읽음 상태는 최댓값 하나로 줄입니다. 메시지마다 읽음 여부를 따로 저장하지 않고, 사용자와 대화마다 last_read_seq 하나만 둡니다. 대화 안의 순서가 정해져 있으므로 "여기까지 읽었다"는 숫자 하나로 충분합니다. 단말도 짧은 시간에 연달아 생긴 읽음 이벤트를 모아 마지막 순번만 보냅니다.
재접속이 한꺼번에 몰릴 때. 한 사용자가 밀린 양은 크지 않습니다. 평균 수신자 6.4명, 1인당 하루 40건 발신이면 한 사람이 하루 약 256건을 받고, 8시간 오프라인 뒤에는 포인터 약 85건이 밀립니다(설계 가정). 묶음 조회 한두 번이면 끝나는 양입니다. 부담은 동시에 재접속하는 단말 수에서 옵니다. 노드당 5만 연결인 Gateway 한 대가 죽으면 5만 단말 × 85건 = 약 425만 행의 조회가 몰립니다.
| 재접속을 흩는 시간 | 초당 재접속 | 초당 조회 행 |
| 5초 | 10,000 | 850,000 |
| 30초 | 약 1,667 | 약 141,667 |
| 60초 | 약 833 | 약 70,833 |
흩는 시간이 초당 부하를 열 배 넘게 바꿉니다. 그래서 단말은 재시도 간격을 지수적으로 늘리고(exponential backoff) 거기에 무작위 흔들림(jitter)을 더해 재접속 시각을 흩어 놓습니다. 아래는 간격을 0부터 상한 사이에서 무작위로 고르는 full jitter 방식입니다. AWS의 2015년 글이 이 방식과 다른 방식을 비교합니다.
void reconnect(long serverHintMillis) throws InterruptedException {
    long capMillis = 60_000;
    long baseMillis = 500;
    long ceiling = baseMillis;

    while (true) {
        long delay = java.util.concurrent.ThreadLocalRandom.current()
                .nextLong(Math.min(capMillis, ceiling) + 1);
        Thread.sleep(Math.max(delay, serverHintMillis)); // 서버가 준 지연 힌트를 우선한다.
        if (connect()) {
            return;
        }
        ceiling = Math.min(capMillis, ceiling * 2);
    }
}
jitter가 없으면 모든 단말이 같은 간격으로 다시 몰려 폭주가 주기적으로 반복됩니다. 상한(CAP)을 60초로 잡으면 운 나쁜 단말은 장애가 5초 만에 풀려도 최대 60초 동안 끊겨 있고, 5초로 잡으면 5만 단말이 5초 안에 몰려 위 표의 첫 줄이 됩니다. 둘 사이 값은 동기화 서비스와 메시지 저장소가 버티는 초당 조회량을 부하 테스트로 재서 정합니다.
서버 쪽에서는 Retry-After 같은 지연 힌트를 내려 주고, 인증과 동기화 API에 별도 처리율 제한을 둡니다. 복구는 최신 메시지부터 작은 묶음으로 하고, 접속 상태나 입력 중 표시 같은 이벤트는 복구 중에 우선순위를 낮춥니다. Slack은 2017년 글에서 엣지에 둔 캐시 Flannel이 새로 붙거나 막 끊겼다 붙은 사용자에게 직접 응답해 재접속 폭주가 뒤쪽 서버에 주는 영향을 줄인다고 설명합니다. 재접속 요청을 뒤쪽 저장소까지 보내지 않는 방법도 있다는 사례입니다.
접속 상태를 만료되는 추정값으로 다루기
마지막 빈칸은 B가 접속 중인지 판단하는 일이었습니다. 책은 터널을 지나는 사용자를 예로 들어, 연결이 끊길 때마다 오프라인으로 바꾸면 안 된다고 설명합니다. 대신 클라이언트가 주기적으로 heartbeat를 보내고, 일정 시간 동안 heartbeat가 없을 때만 오프라인으로 바꿉니다. 책의 예시는 5초 간격으로 보내다가 30초 동안 받지 못하면 오프라인으로 바꾸는 것이고, 30초는 설명을 위해 임의로 고른 값이라고 밝힙니다. 제 설계에서는 heartbeat를 20초마다 보내고, 판정 시간은 그 세 배인 60초로 정했습니다. heartbeat 두 번을 연속으로 놓쳐도 온라인으로 두고, 60초 동안 아무것도 오지 않을 때 오프라인으로 바꿉니다.
저는 온라인과 오프라인 사이에 "응답이 늦는 중(Suspect)"을 하나 더 두었습니다(원문 밖 확장). 이렇게 갱신이 멈추면 저절로 사라지는 상태를 soft state라고 부릅니다.
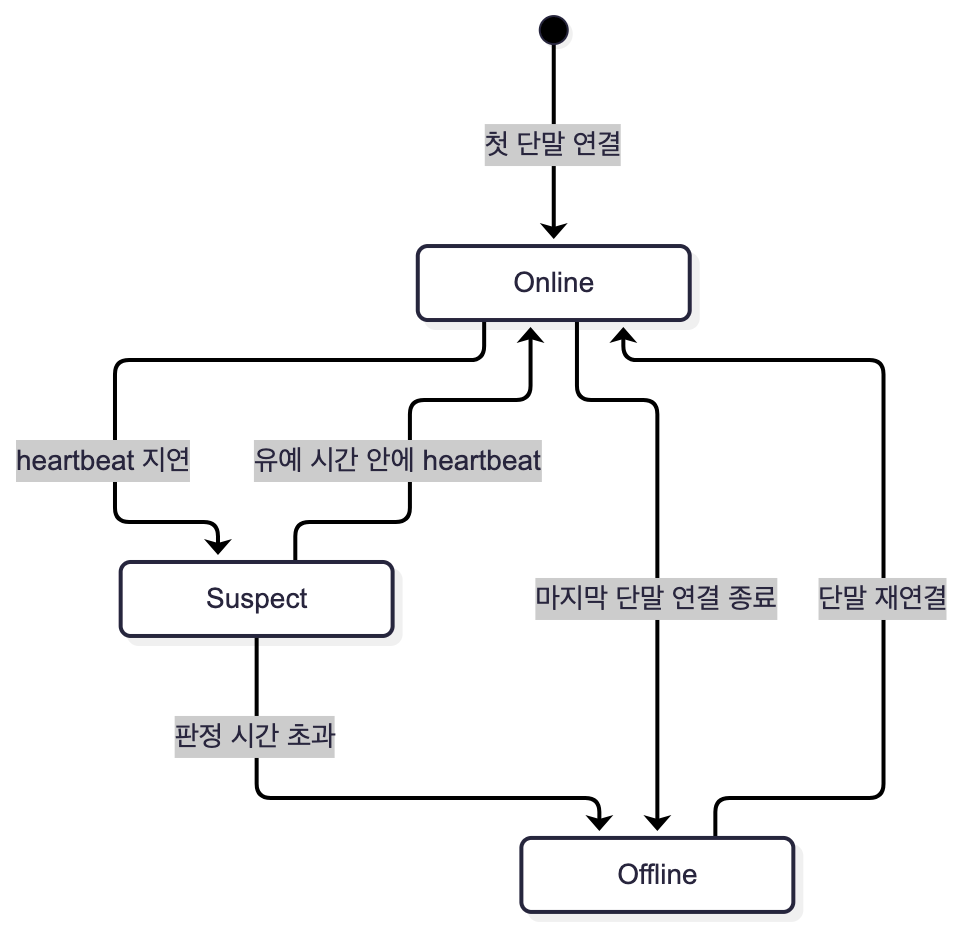
그림에서 볼 것은 heartbeat가 한 번 늦었다고 곧바로 Offline으로 가지 않는다는 점입니다. Suspect는 서버 안에서만 쓰는 상태라 친구 화면에는 여전히 온라인으로 보입니다. 판정 시간을 짧게 잡는 경우와 길게 잡는 경우가 모두 틀립니다. 40초로 잡으면 놓쳐도 되는 heartbeat가 한 번뿐이라, 45초 동안 신호가 끊기는 구간을 지나는 사용자가 오프라인이 됐다가 돌아오며 친구 화면에서 상태가 깜빡입니다. 300초로 잡으면 앱을 강제 종료한 사용자가 5분 동안 온라인으로 보입니다. 60초에도 틀리는 경우가 있습니다. 90초 동안 끊기는 지하철 구간에서는 상태가 깜빡이고, 앱을 강제 종료한 사용자는 최대 60초 동안 온라인으로 보입니다. 책처럼 주기의 여섯 배를 두면 120초라서 이 시간이 2분으로 늘어나므로 세 배를 골랐습니다. 운영에서는 연결이 끊긴 뒤 같은 단말이 다시 붙기까지 걸린 시간의 분포를 모아, 그 p95가 60초에서 크게 벗어나면 판정 시간을 옮깁니다.
매 heartbeat를 중앙에 쓰지 않습니다. 앞에서 계산한 초당 25만 건을 그대로 중앙 저장소에 쓰지 않도록, Gateway가 연결별 heartbeat와 타임아웃을 자기 메모리에서 관리합니다. 중앙 Presence Store에는 다음 일만 모아서 또는 긴 주기로 반영합니다.
- 사용자의 첫 단말이 연결됨: 오프라인에서 온라인으로
- 마지막 단말이 끊기거나 만료됨: 온라인에서 오프라인으로
- 연결을 맡은 Gateway가 바뀜
- 오래 유지되는 연결의 만료 시간 갱신
사용자당 하루 접속과 종료를 각 20회로 가정하면 상태 전이는 초당 약 23,148건이고, 5백만 연결이 60초마다 만료 시간을 연장하면 초당 약 83,333건입니다(설계 가정). 합쳐도 초당 약 10만 건으로, heartbeat를 모두 쓰는 경우(25만 건)의 절반 아래입니다. 만료 시간 연장 주기를 10초로 줄이면 초당 50만 건이 되어 오히려 heartbeat보다 많아지므로, 연장 주기는 heartbeat 주기보다 길어야 이 분리가 의미가 있습니다. 반대로 600초로 늘리면 Gateway가 죽었을 때 그 서버의 사용자가 10분 넘게 온라인으로 남습니다.
한 사용자가 여러 단말로 접속할 수 있으므로 단말 하나가 끊겼다고 사용자를 오프라인으로 바꾸지 않습니다. 사용자의 활성 단말 연결 수가 0이 될 때만 상태를 바꿉니다.
전파 범위를 제한합니다. 책은 친구 관계마다 발행-구독 채널을 두어, A의 상태가 바뀌면 A-B, A-C, A-D 채널에 쓰고 각 친구가 구독하게 합니다(원문). 그리고 그룹 하나에 10만 명이 있으면 상태 변화 한 번에 이벤트 10만 개가 생기므로, 그룹에 들어갈 때만 상태를 읽게 하거나 수동으로 갱신하게 하자고 제안합니다. 이 곱셈을 서비스 전체로 넓혀 보았습니다. 친구 수를 평균 200명으로 가정하면(설계 가정) 다음과 같습니다.
| 전파 대상 | 초당 이벤트 | 계산 |
| 친구 전원 | 약 463만 | 23,148 × 200 |
| 온라인 친구만(10%) | 약 46만 | 위 × 0.1 |
| 지금 화면에서 보고 있는 친구만(온라인의 10%, 설계 가정) | 약 4.6만 | 위 × 0.1 |
친구 전원에게 보내면 피크 메시지 유입의 20배이고, 친구 수를 20명으로 줄여도 초당 약 46만 건으로 메시지 유입의 두 배입니다. 그래서 상태 변화는 다음 대상에게만 밀어 보내고, 나머지는 화면에 들어갈 때 모아서 조회하게 했습니다(원문 밖 확장).
- 지금 열려 있는 대화의 참여자
- 화면에 보이는 친구 목록
- 접속 상태를 명시적으로 구독한 세션
Slack은 2017년 글에서 접속 상태 갱신을 구독 방식으로 옮긴 뒤 클라이언트가 받는 접속 상태 이벤트가 5분의 1로 줄었다고 밝혔습니다. 이 방식이 틀리는 경우도 있습니다. 친구 목록이 앱을 켜면 처음 나오는 화면이라면 앱을 켠 사람은 모두 친구 목록을 보고 있으므로, 표의 마지막 줄이 둘째 줄로 돌아갑니다. 줄어드는 정도는 화면 설계에 달려 있습니다. 모든 친구와 모든 그룹에 미리 보내면 관계가 많은 사용자 한 명의 상태 변화가 특정 키에 쓰기를 몰아주는 hot key가 되므로, 대신 접속 상태가 몇 초 늦게 보일 수 있다는 것을 제품 계약으로 둡니다.
공부하고 나서 남은 것
설계 문서를 다 쓰고 보니 분량 대부분은 웹소켓이 아니라 책이 비워 둔 세 가지, 곧 성공 응답을 언제 보내는지, 전달한 메시지를 다시 찾을 수 있는지, 상대가 접속 중인지를 어떻게 판단하는지에 쓰였습니다. 상태를 연결, 메시지, 대화로 나누고, 수락과 저장과 전달의 순서를 정하고, 재접속을 위치 표시 이후를 채우는 일로 바꾸고 나니 책의 구성 요소 하나하나가 어떤 약속을 지키려고 있는지 설명할 수 있게 되었습니다. 1차 판에서 병렬이던 저장과 전달을 최신판에서 차례로 바꾼 것도, 전달된 메시지를 다시 조회할 수 있어야 한다는 약속 때문이었습니다.
숫자를 다루면서 배운 것은 가정을 섞지 않는 일입니다. 책의 동시 접속 100만과 제 5백만은 같은 공식에서 다섯 배 차이를 만들고, 책의 5초 heartbeat와 제 5백만 연결을 섞으면 어느 쪽 가정에도 없는 초당 100만 건이 나옵니다. 노드당 연결 수, heartbeat 주기, 로그 보존 기간, 재접속을 흩는 시간은 모두 계산으로는 범위만 정해지고, 값은 부하 테스트와 운영 지표로 정해집니다. 각 값에 무엇을 재야 하는지를 함께 적어 둔 이유입니다.
아직 풀지 않은 것은 I2, 곧 같은 대화의 메시지를 모든 참여자가 같은 순서로 보게 하는 방법입니다. 이 글에서는 대화마다 순서를 정하는 담당자가 하나 있다고 전제만 했습니다. 다음 편에서는 그 담당자를 하나로 유지하는 방법과, 담당자가 바뀌는 순간에 생기는 문제를 다룹니다.
참고 자료
책
- 알렉스 쉬, 『가상 면접 사례로 배우는 대규모 시스템 설계 기초』, 이병준 옮김, 인사이트, 2021: https://www.yes24.com/Product/Goods/102819435
표준 문서와 공식 문서
- RFC 6455, The WebSocket Protocol (2011): https://www.rfc-editor.org/rfc/rfc6455
- RFC 3629, UTF-8, a transformation format of ISO 10646 (2003): https://www.rfc-editor.org/rfc/rfc3629
- HTML Standard, Server-sent events: https://html.spec.whatwg.org/multipage/server-sent-events.html
- AWS, Edit attributes for your Application Load Balancer (유휴 타임아웃 기본 60초): https://docs.aws.amazon.com/elasticloadbalancing/latest/application/edit-load-balancer-attributes.html
- Chris Richardson, Pattern: Transactional outbox: https://microservices.io/patterns/data/transactional-outbox.html
- Marc Brooker, Exponential Backoff And Jitter (AWS Architecture Blog, 2015): https://aws.amazon.com/blogs/architecture/exponential-backoff-and-jitter/
실제 서비스 사례
- 1 million is so 2011 (WhatsApp, 2012): https://blog.whatsapp.com/1-million-is-so-2011
- Rick Reed, That's Billion with a B: Scaling to the Next Level at WhatsApp (Erlang Factory, 2014): https://www.erlang-factory.com/static/upload/media/1394350183453526efsf2014whatsappscaling.pdf
- How Discord Scaled Elixir to 5,000,000 Concurrent Users (Discord, 2017): https://discord.com/blog/how-discord-scaled-elixir-to-5-000-000-concurrent-users
- Real-time Messaging (Slack, 2023): https://slack.engineering/real-time-messaging/
- Flannel: An Application-Level Edge Cache to Make Slack Scale (Slack, 2017): https://slack.engineering/flannel-an-application-level-edge-cache-to-make-slack-scale/
- Building Mobile-First Infrastructure for Messenger (Facebook, 2014): https://engineering.fb.com/2014/10/09/production-engineering/building-mobile-first-infrastructure-for-messenger/
- Migrating Messenger storage to optimize performance (Facebook, 2018): https://engineering.fb.com/2018/06/26/core-infra/migrating-messenger-storage-to-optimize-performance/
- 카카오톡 메시징 시스템 재건축 이야기 (if(kakao), 2022): https://speakerdeck.com/kakao/kakaotog-mesijing-siseutem-jaegeoncug-iyagi
- How LINE messaging servers prepare for New Year's traffic (LINE): https://engineering.linecorp.com/en/blog/how-line-messaging-servers-prepare-for-new-years-traffic/
책의 참고문헌 가운데 지금 열리는 것 (원래 주소가 열리지 않는 것은 현재 주소로 적었습니다)
- Erlang at Facebook (Eugene Letuchy, 2009): https://www.erlang-factory.com/upload/presentations/31/EugeneLetuchy-ErlangatFacebook.pdf
- Long tail (Wikipedia): https://en.wikipedia.org/wiki/Long_tail
- The Underlying Technology of Messages (Facebook, 2010): https://engineering.fb.com/2010/11/15/core-infra/the-underlying-technology-of-messages/
- How Discord Stores Billions of Messages (Discord, 2017): https://discord.com/blog/how-discord-stores-billions-of-messages
- Apache ZooKeeper: https://zookeeper.apache.org/
- 从无到有:微信后台系统的演进之路 (InfoQ, 중국어): https://www.infoq.cn/article/the-road-of-the-growth-weixin-background
'스터디' 카테고리의 다른 글
| [대규모 시스템 설계 스터디] 채팅 시스템 설계 3편 Kafka 대입 (0) | 2026.10.10 |
|---|---|
| [대규모 시스템 설계 스터디] 채팅 시스템 설계 2편 순서 보장 (0) | 2026.10.09 |
| [대규모 시스템 설계 스터디] 뉴스 피드 시스템 설계 (0) | 2026.10.09 |
| [Sutskever's List 스터디] dropout의 자리와 CTC를 계산해 본 후기 (0) | 2026.10.05 |
| [Sutskever's List 스터디] AlexNet, ResNet, LSTM을 읽고 계산해 본 후기 (0) | 2026.10.05 |