채팅 메시지의 순서를 대화별 단일 writer와 세대 번호로 지키는 방법
1편에서 『가상 면접 사례로 배우는 대규모 시스템 설계 기초』 12장의 채팅 시스템을 출발점으로 전체 구조를 정리하면서, 순서 문제는 따로 다루겠다고 남겨 두었습니다. 설계 문서를 쓰는 동안 가장 오래 붙잡고 있던 질문이 "같은 대화에 있는 사람들이 모두 같은 순서로 메시지를 보게 하려면 무엇이 필요한가"였기 때문입니다.
이 질문은 번호를 어디서 붙이느냐에서 시작해, 번호를 붙이는 서버가 바뀌는 순간 이전 서버를 어떻게 막느냐로 이어졌습니다. 이 편에서는 그 순서대로 제가 공부하고 설계한 내용을 적습니다. 쉽게 말해 단말 시계에 찍힌 시간이 아니라 서버가 대화마다 매긴 번호를 모두가 같은 순서로 보게 하는 문제입니다.
1편에서 설명한 용어 세 가지를 먼저 다시 적어 둡니다.
- ID 세 개: 송신 단말이 만드는 client_message_id(재시도 중복 제거용), 서버가 만드는 message_id(메시지를 가리키는 고유 ID), 대화 안의 순서를 나타내는 conversation_seq입니다.
- ACCEPTED: 서버가 메시지를 여러 노드에 복제되는 로그에 기록한 뒤에만 송신자에게 돌려주는 "수락됨" 응답입니다.
- 불변 조건 I1~I5: 설계 전체가 지켜야 할 규칙 다섯 개입니다. 이 편에서는 그중 두 개를 씁니다. I1은 "성공 응답을 받은 메시지는 복구할 수 있다", I2는 "같은 대화의 메시지는 하나의 서버 순서로 모인다"입니다.
이 편에서 "로그 저장소"라고 부르는 것은 기록을 뒤에 덧붙이기만 하는 추가 전용 로그(append-only log)이고, 여러 노드에 복제되어 있다고 가정합니다. 어떤 제품으로 만들지는 이 편에서 정하지 않고, 역할만 씁니다. 글에 나오는 수치 가운데 제가 계산을 위해 정한 값은 설계 가정이라고 표시했습니다.
순서를 지키는 쪽에서 본 전체 구조
1편의 전체 경로에서 이 글이 자세히 다루는 곳은 Router부터 복제 로그까지입니다. 대화가 속한 virtual shard의 담당 worker를 찾아 명령을 보내고, 그 worker가 대화별로 하나씩 참여자 확인, 중복 제거, 순번 부여를 처리합니다. 담당자가 바뀔 때는 coordinator가 lease를 새 worker에게 줍니다. 새 담당자가 로그에 자신의 세대를 등록한 뒤에는 로그 저장소가 이전 담당자의 새 기록을 거부해야 합니다.
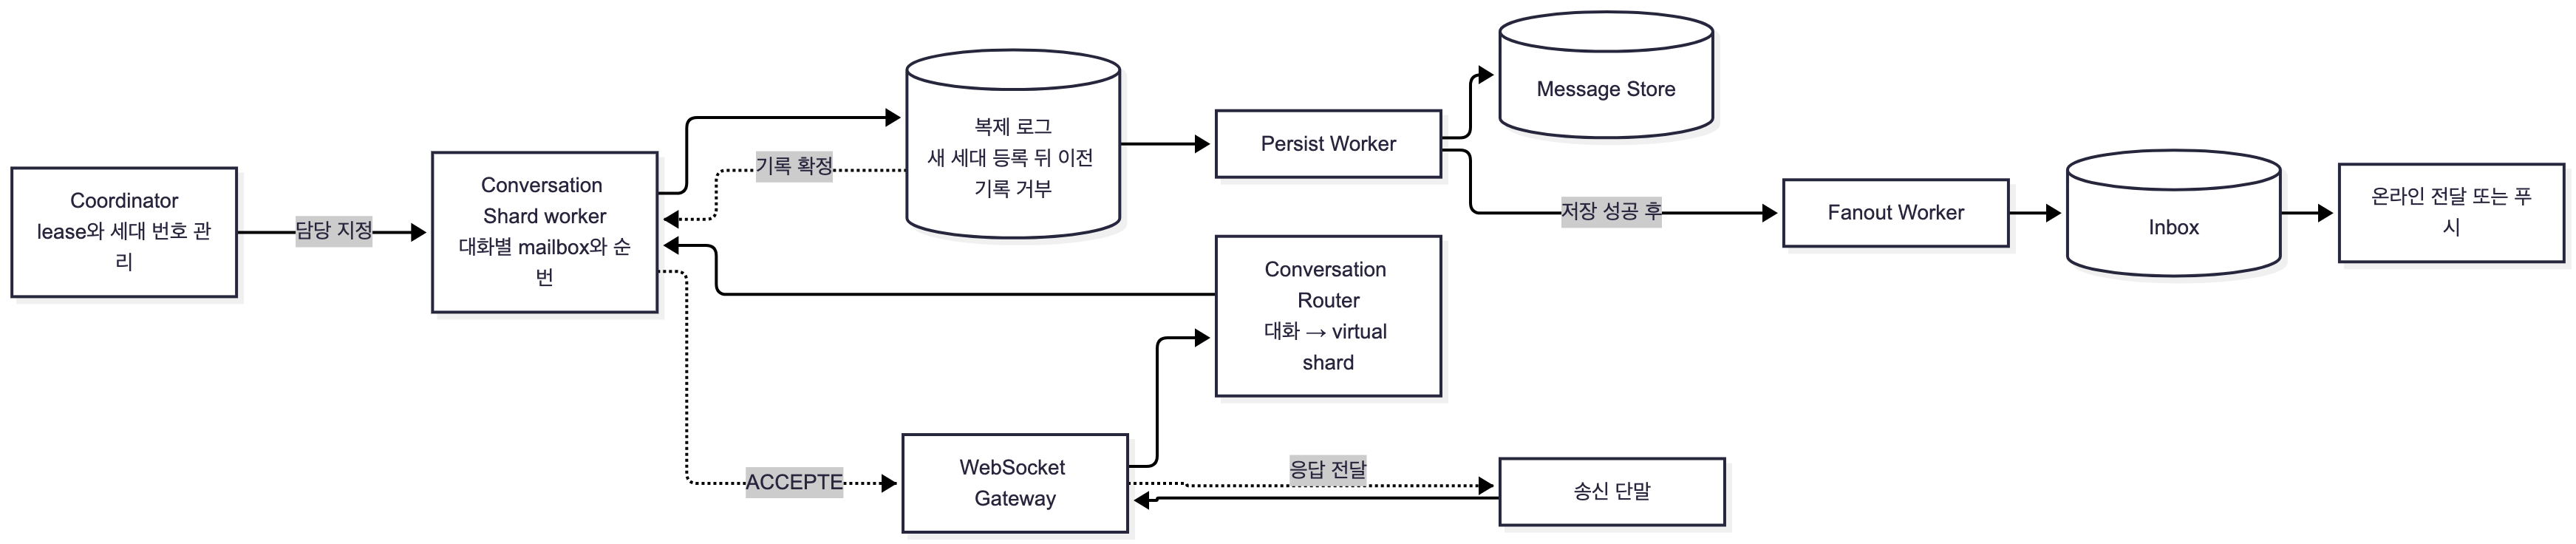
Router는 대화의 담당자를 찾아 줄 뿐 순번을 붙이지 않습니다. lease는 담당자를 정하고, 세대 번호 검사는 이전 담당자의 늦은 기록을 막습니다. 로그 구현 기술은 여기서 확정하지 않고 3편에서 Kafka로 구체화합니다.
1. 클라이언트 시각으로 순서를 정할 수 없는 이유
두 사람이 같은 대화방에 거의 동시에 메시지를 보냈다고 해 보겠습니다.
A가 "밥 먹자" 전송        13:00:00.100 (A의 폰 시계)
B가 "어디서?" 전송        13:00:00.090 (B의 폰 시계)

서버 도착: A가 먼저, B가 나중 (네트워크 지연 차이)
핸드폰 시계로 보면 B가 먼저이고, 서버 도착으로 보면 A가 먼저입니다. 핸드폰 시계는 사용자가 바꿀 수 있고 기기마다 조금씩 어긋나 있으므로, 이 시각으로 정렬하면 단말마다 순서가 달라질 수 있습니다. 책도 메시지 테이블을 설명하면서 created_at으로는 순서를 정할 수 없다고 말합니다. 서로 다른 두 메시지가 같은 시각에 만들어질 수 있기 때문입니다.
서버 시각으로 바꿔도 문제가 남습니다. 책이 참고하는 트위터의 Snowflake는 시각을 상위 비트에 넣은 64비트 ID를 서버마다 따로 만드는 방식인데, 공개 저장소(2010년)의 README는 서로 다른 서버가 만든 ID의 정렬을 "1초 범위 안의 대략 정렬(k-sorted)"로만 약속합니다. 그룹 대화에서 1초 안에 두 사람이 말하는 일은 흔하므로, 서버 시각 기반 ID로 정렬하면 같은 대화의 두 메시지가 뒤집힐 수 있습니다.
그러면 어느 쪽이 "진짜" 먼저일까요. 저는 설계 문서에 이렇게 적었습니다.
여기서 보장하는 것은 서버가 수락한 순서다. 두 사용자가 거의 동시에 보낸 메시지의 현실 세계 절대 순서는 알 수 없고 필요하지도 않다. 모든 참여자의 화면이 하나의 서버 순서로 모이면 된다.
사용자에게 필요한 것은 현실 세계의 정확한 선후가 아니라, A의 화면과 B의 화면과 같은 방에 있는 C의 화면이 모두 같은 순서를 보여 주는 것입니다. 그러려면 서버 어딘가 한 곳이 "이것이 105번, 이것이 106번"이라고 번호를 붙이고, 모든 단말이 그 번호로 정렬해야 합니다.
아래 그림은 번호를 붙이는 곳이 하나일 때, 단말마다 도착 순서가 달라도 화면 순서가 같아지는 과정을 보여 줍니다.
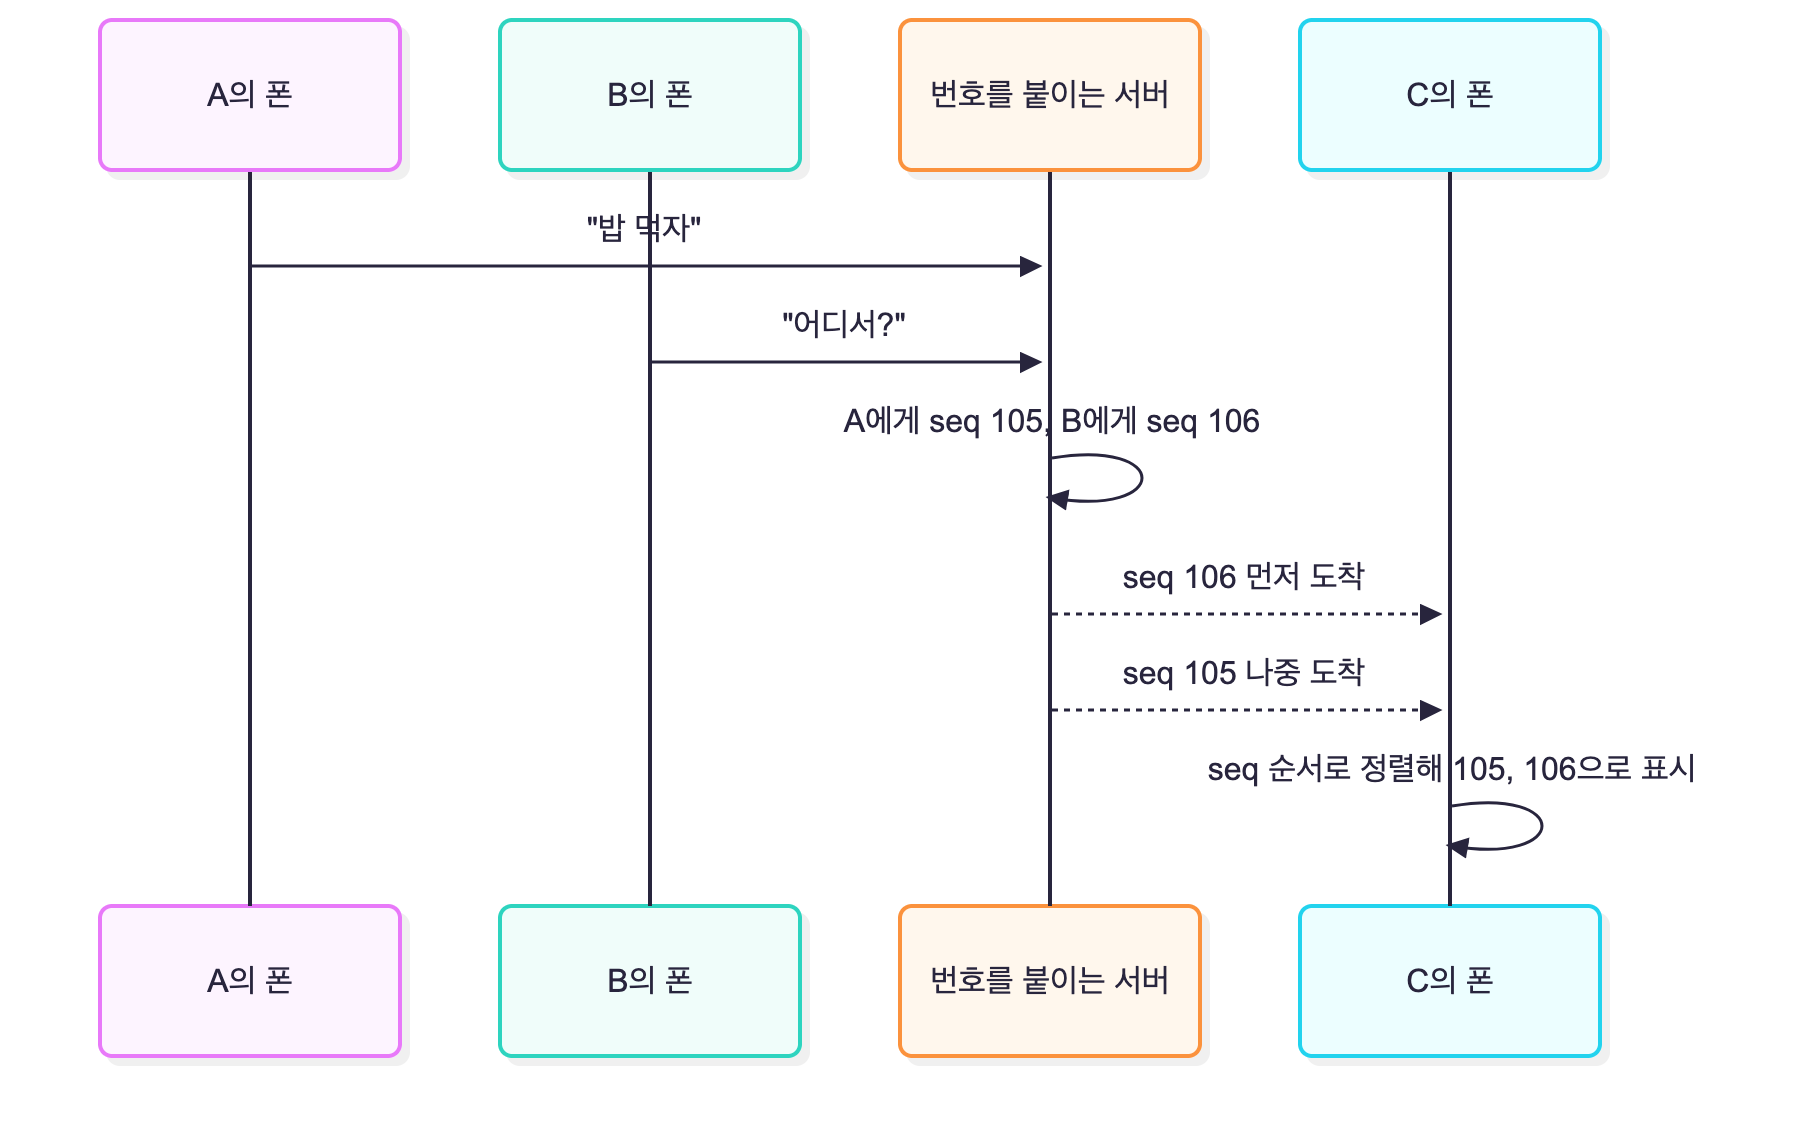
- 폰 시계는 번호를 정하는 데 쓰이지 않습니다. 서버에 도착한 순서로 한 곳에서 번호를 붙입니다.
- C의 폰에는 106이 먼저 도착했지만, 화면은 도착 순서가 아니라 seq 순서로 그립니다.
- 그래서 A, B, C 세 단말이 모두 같은 순서를 봅니다. 이 편의 나머지는 이 번호를 누가, 어디서, 어떻게 안전하게 붙이는지에 대한 이야기입니다.
2. 전역 순서 대신 대화별 순서를 택한 이유
번호를 붙이는 범위부터 정해야 했습니다. 시스템 전체의 모든 메시지에 하나의 순서를 매기는 전역 순서와, 대화 하나 안에서만 순서를 매기는 대화별 순서가 있습니다.
전역 순서를 만들려면 모든 대화의 메시지를 한 줄로 세워야 합니다. 번호를 매기는 곳이 한 군데여야 하거나, 여러 곳이 번호를 매기더라도 서로 조율해야 합니다. 대화가 수천만 개 있는 서비스에서 서로 관계없는 두 대화의 메시지 중 어느 쪽이 먼저인지를 맞추는 일은 비용만 들고 사용자에게 보이는 이득이 없습니다. A와 B의 대화방 메시지와 C와 D의 대화방 메시지는 같은 화면에 섞여 나오지 않기 때문입니다.
책도 메시지 ID를 만드는 방법을 설명하면서 같은 결론에 닿습니다. 책이 드는 방법은 세 가지입니다. 관계형 데이터베이스의 auto_increment, 스노플레이크 같은 전역 64비트 순서 번호 생성기, 그리고 지역적 순서 번호 생성기입니다. 마지막 방법은 ID의 유일성을 같은 대화 안에서만 보장하면 된다는 발상이고, 책은 메시지 순서가 같은 채널이나 같은 1:1 채팅 안에서만 유지되면 충분하므로 이 방법이 통하며 전역 생성기보다 구현하기 쉽다고 설명합니다.
저는 이 지역적 순서 번호를 conversation_seq로 받아들였습니다. 다만 책이 "구현하기 쉽다"고 한 데에는 전제가 하나 있다고 봤습니다. 한 채널에 번호를 붙이는 곳이 하나라는 전제입니다. 같은 채널의 메시지가 서로 다른 채팅 서버 두 대에 동시에 들어와 두 서버가 각자 번호를 붙이면, 같은 번호가 두 번 나오거나 서버마다 순서가 갈립니다. 지역 번호가 쉬운 것은 번호를 붙이는 곳이 대화마다 하나일 때뿐이고, 그 "하나"를 만드는 것이 4절부터의 내용입니다.
전역 순서가 필요한 경우가 아예 없지는 않습니다. 설계 문서의 트레이드오프 표에는 "글로벌 감사 순서가 법적 요구일 때"를 대화별 순서를 바꿔야 하는 조건으로 적어 두었습니다. 감사 요건이 모든 대화에 걸친 단일 순번까지 요구한다면, 모든 대화의 기록을 조율하는 비용을 감수하고 이 편의 설계를 다시 따져야 합니다. 감사 기록에 시각과 대화별 순서만 있으면 되는 요구라면 전역 순번은 필요하지 않습니다. 사용자의 대화 목록을 "마지막 메시지가 최근인 대화부터" 정렬하는 일도 대화를 넘는 비교라서 conversation_seq로는 할 수 없고 서버 시각이나 사용자별 이벤트 번호를 씁니다. 대화 목록 순서가 몇 밀리초 차이로 바뀌는 것은 대화 안의 순서가 뒤집히는 것만큼 문제가 되지 않습니다.
3. ID 세 개를 순서 관점에서 다시 보기
책은 message_id 하나에 두 가지 성질을 요구합니다. 값이 고유해야 하고, 정렬 가능하며 시간 순서와 일치해야 합니다. 저는 이 두 책임을 한 ID에 두지 않고 나눴습니다.
| 식별자 | 누가 만드는가 | 순서와의 관계 |
| client_message_id | 송신 단말 | 순서와 무관합니다. 같은 메시지를 다시 보냈을 때 같은 것으로 알아보는 용도입니다 |
| message_id | 서버 | 순서와 무관합니다. 답장, 신고, 검색 색인처럼 대화 밖에서 이 메시지를 가리키는 이름입니다 |
| conversation_seq | 대화의 순서를 정하는 Conversation Shard(4절) | 한 대화 안의 표시 순서와 동기화 순서를 정합니다 |
이렇게 나누면 message_id는 고유하기만 하면 되고, 정렬은 conversation_seq가 맡습니다. 수신 단말은 메시지가 도착한 순서가 아니라 conversation_seq 순서로 화면에 그리고, 같은 message_id가 두 번 오면 하나를 버립니다. 이 규칙을 지키지 않고 클라이언트가 message_id로 정렬하면, 시각 기반 ID의 순서가 서버가 정한 순서와 달라 참여자마다 화면이 달라질 수 있습니다. 그래서 정렬 키는 conversation_seq 하나라는 것을 프로토콜 규칙으로 적어 두었습니다.
void onDeliver(Message msg) {
    view.insertSorted(msg, java.util.Comparator.comparingLong(Message::conversationSeq));
    view.showTime(msg, msg.createdAt()); // 시각은 화면 표시에만 쓴다.
}
설계하면서 따로 적어 둔 것이 하나 있습니다. conversation_seq는 빈틈없는 연속 번호일 필요가 없습니다. 명령 하나가 처리 도중 실패해 105번이 비고 106번으로 넘어가도, 사용자가 보는 순서의 의미는 달라지지 않습니다. 필요한 성질은 두 가지입니다. 같은 대화 안에서 번호가 계속 커져야 하고(단조 증가), 같은 번호가 두 메시지에 붙으면 안 됩니다.
실제 서비스에도 같은 판단이 있습니다. WeChat은 사용자마다 계속 커지는 순서 번호를 주는 전용 서비스(seqsvr)를 두는데, 설계 글에서 "증가만 요구하고 연속은 요구하지 않는다"고 밝힙니다(텐센트 클라우드 개발자 커뮤니티 게재본, 2017년 수정 기준). 번호가 연속이 아니어도 되니, 저장소에는 현재 번호 대신 미리 확보한 상한값만 10,000 단위로 기록해, 저장소 입출력을 초당 약 10^7건에서 약 10^3건으로 줄였다고 설명합니다. WeChat은 사용자별이고 제 설계는 대화별이라는 차이는 있지만, "순서 번호에 빈틈을 허용한다"는 선택은 같습니다.
빈틈 허용에는 대가도 있습니다. 클라이언트가 번호 간격으로 누락을 판단할 수 없습니다. 105 다음에 107이 왔다고 106을 요청하면, 106은 원래 없는 번호일 수 있습니다. 이렇게 잘못 구현한 클라이언트는 정상적인 빈틈마다 없는 메시지를 계속 요청합니다. 그래서 누락은 번호 간격이 아니라 1편에서 다룬 사용자별 동기화 위치(last_sync_event_id)로 찾습니다. 반대로 세금 계산서 번호처럼 빈틈 자체가 감사 대상인 도메인에서는 이 선택을 쓸 수 없습니다. 채팅에는 그런 요구가 없습니다.
빈틈을 허용하면 테스트 기준도 바뀝니다. 번호 사이 간격이 1인지를 검사하는 테스트는 의미가 없고, 대신 다음 세 가지를 검사합니다. 8절에서 이 세 가지를 코드로 적습니다.
- ACCEPTED를 받은 메시지가 빠지지 않았는가(누락)
- 같은 대화에서 같은 seq가 두 메시지에 붙지 않았는가(충돌)
- 나중에 수락된 메시지가 더 작은 seq를 받지 않았는가(역행)
4. 대화별 단일 writer와 virtual shard
번호를 붙이는 곳이 대화마다 한 군데여야 누락, 충돌, 역행을 막기 쉽습니다. 그래서 설계에서는 대화 하나에 대해 한 시점에 번호를 매기는 쓰기 담당(writer)을 하나만 둔다는 규칙을 정했습니다. 이것을 대화별 단일 writer라고 부릅니다. 1편의 I2가 말하는 "한 대화의 명령은 한 곳에서 차례로 처리한다"를 만드는 방법입니다.
이 역할을 하는 컴포넌트가 Conversation Shard입니다. Shard는 대화의 명령을 받아 세 가지를 같은 자리에서 합니다. 보낸 사람이 아직 대화 참여자인지 확인하고(멤버십 검사), 이미 처리한 재시도인지 확인하고(중복 제거), conversation_seq를 붙인 뒤 로그 저장소에 기록합니다.
대화를 서버에 바로 나누지 않는 이유
대화를 서버에 배정하는 가장 단순한 방법은 hash(conversation_id) % 서버 수입니다. 이 방법은 서버 수가 바뀌는 순간 대부분의 대화가 다른 서버로 옮겨 갑니다. 해시값을 두 서버 수의 최소공배수로 나눈 나머지를 세어 보면 옮겨 가는 비율이 나옵니다.
| 서버 수 변경 | 자리를 지키는 대화 | 옮겨 가는 대화 |
| 4대에서 8대로 | h mod 8 < 4 인 것, 50% | 50% |
| 4대에서 5대로 | h mod 20의 20칸 중 4칸, 20% | 80% |
| 8대에서 9대로 | 약 1/9, 약 11% | 약 89% |
한 대만 늘려도 대부분의 대화가 이동하고, 두 배로 늘릴 때만 절반이 남습니다. 대화가 옮겨 가는 동안에는 같은 대화의 명령이 이전 서버와 새 서버에 나뉘어 들어올 수 있고, 그 순간 단일 writer가 깨집니다. 이 위험이 전체 대화의 80%에 퍼지는 셈입니다.
그래서 중간에 한 단계를 둡니다. 대화를 개수가 고정된 논리 묶음(virtual shard)에 먼저 대응시키고, 서버에는 묶음 단위로 담당을 맡깁니다.
conversation_id → virtual shard   고정 (hash % 4096, 바꾸지 않음)
virtual shard   → worker          바뀔 수 있음 (담당 표)
아래 그림은 명령이 대화에서 virtual shard, worker, 대화별 대기열로 내려가는 경로를 보여 줍니다.
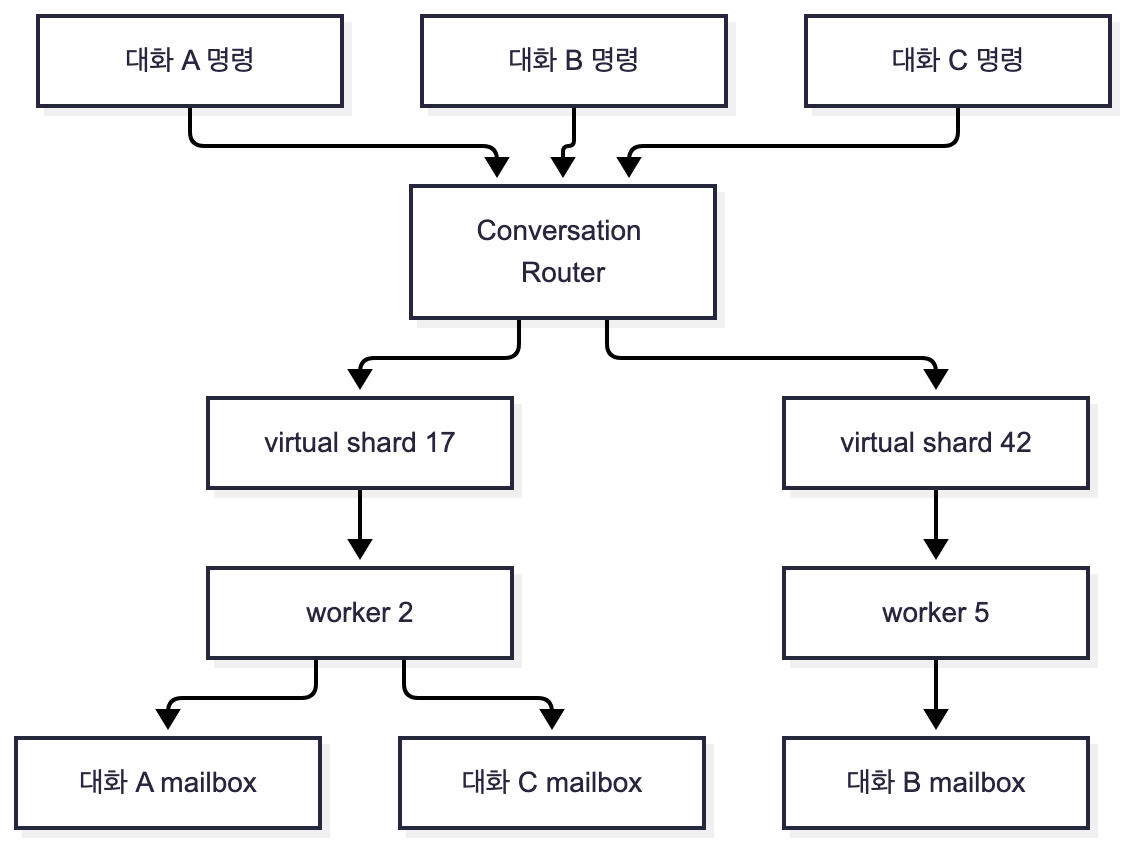
- Conversation Router는 conversation_id를 해시해 virtual shard 하나를 고릅니다. 같은 대화는 항상 같은 칸으로 갑니다. 이 그림에서는 대화 A와 C가 같은 virtual shard 17에 속한다고 가정했습니다.
- virtual shard 하나는 한 시점에 worker 하나가 맡습니다. worker를 늘릴 때는 대화를 다시 나누지 않고 담당 표에서 일부 칸의 담당만 바꿉니다. 4,096칸을 8대에서 16대로 나누면 2,048칸의 담당만 바뀌고(한 대당 512칸에서 256칸으로), 대화의 소속은 0%가 옮겨 갑니다.
- 맨 아래의 mailbox는 대화 하나에 들어온 명령을 쌓아 두는 대기열입니다. 이것이 실제로 순서를 지키는 단위입니다.
칸을 고정해 두면 옮겨 가는 것은 "칸의 담당자"뿐이고, 담당자를 바꾸는 절차 하나만 안전하게 만들면 됩니다. 그 절차가 5절과 6절의 내용입니다. 대가도 분명합니다. Router, 담당 표, 담당을 관리하는 coordinator를 직접 운영해야 하고, 담당 표가 Router마다 다르게 보이는 동안에는 같은 대화의 명령이 두 worker로 갈 수 있습니다. 이 경우 두 worker가 모두 기록을 시도하게 되는데, 이 충돌을 막는 방법도 6절에서 다룹니다.
단일 writer는 단일 스레드가 아니다
단일 writer라는 말을 처음 적었을 때 저도 헷갈렸던 것이 있어 설계 문서에 따로 풀어 두었습니다. 단일 writer는 단일 스레드가 아닙니다. worker 하나는 여러 대화를 병렬로 처리합니다. 한 번에 하나씩만 처리하는 단위는 대화별 mailbox입니다. 대화 A의 명령은 A의 mailbox에서 하나씩 처리되고, 그동안 대화 B의 명령은 B의 mailbox에서 따로 처리됩니다. virtual shard는 라우팅과 장애 조치의 단위이고, 순서를 실제로 보장하는 단위는 대화입니다.
아래 Java에서 mailboxes.submit은 같은 대화의 작업을 하나씩 실행하는 큐이고, 다른 대화의 큐는 병렬로 실행된다고 가정합니다. 번호를 붙인 뒤 로그 기록이 실패하면 성공 응답은 보내지 않습니다.
void onCommand(Command cmd) {
    int shard = virtualShardOf(cmd.conversationId());
    String owner = ownerTable.ownerOf(shard);
    if (!owner.equals(thisWorkerId)) {
        redirect(cmd, owner);
        return;
    }
    mailboxes.submit(cmd.conversationId(), () -> processInOrder(cmd));
}

void processInOrder(Command cmd) {
    checkMembership(cmd);
    long seq = lastSeq.getOrDefault(cmd.conversationId(), 0L) + 1;
    lastSeq.put(cmd.conversationId(), seq); // 번호를 예약한다. 기록 실패 시 되돌리지 않는다.
    log.appendAndWait(cmd, seq);            // 확정된 뒤에만 ACCEPTED를 보낸다.
    replyAccepted(cmd, seq);
}
위 코드는 실패 시 번호를 되돌리지 않는 한 가지 구현 예시입니다. 같은 실행 중에 다음 명령이 오면 번호에 빈틈이 생길 수 있습니다. 담당자가 교체돼 replay로 다시 시작할 때는 메모리의 예약 번호가 아니라 확정된 로그의 마지막 번호에서 이어 가므로, 확정되지 않은 번호를 다시 사용할 수도 있습니다. 어느 경우든 두 메시지가 같은 번호로 확정되면 안 됩니다.
멤버십 변경도 같은 경로로 지나게 했습니다. 관리자가 사용자를 강퇴하는 명령도 Shard를 거쳐 번호를 받고 로그에 기록됩니다. 그러면 강퇴와 메시지의 선후가 같은 번호 체계 안에서 정해집니다.
mailbox[c]: [JOIN u3 → seq 99] [KICK u2 → seq 100] [SEND from u2]
SEND from u2 처리 시 members[c]에 u2가 없음 → REJECT(권한 없음), seq를 붙이지 않음
강퇴 명령과 메시지 송신이 거의 동시에 들어와도 판정이 한 곳에서 한 순서로 이뤄집니다. 멤버십 검사를 번호를 붙이는 곳과 다른 자리에서 하면 이 성질이 사라집니다. 번호를 붙이기 전에 검사하려면 검사하는 쪽이 멤버십의 정본을 가져야 하고, 붙인 뒤에 검사하면 권한 없는 메시지가 이미 로그에 들어간 뒤에 걸러야 합니다.
virtual shard 개수 4,096의 근거와 반례
virtual shard 개수는 한 번 정하면 바꾸기 어렵습니다. 바꾸는 것은 대화의 소속을 바꾸는 일이라, 처음 피하려던 재배치를 다시 하게 됩니다. 저는 4,096개(설계 가정)로 두고 양 끝 값을 넣어 무엇이 달라지는지 계산했습니다. 4,096은 worker를 최대 100대까지 늘려도 한 대가 약 41칸을 나눠 맡을 수 있게 잡은 값입니다. 입력은 피크 메시지 유입 초당 약 231,480건입니다. 이 값은 1편의 용량 추정에서 DAU 5,000만 명 × 1인당 하루 40건 ÷ 86,400초 × 피크 배수 10으로 계산한 설계 가정입니다. 담당 갱신 부하는 5절에서 다룰 담당 기한(lease)을 칸마다 3초에 한 번씩 갱신한다고 두고 계산했습니다.
| virtual shard 수 | 칸 하나의 평균 부하 | 최대 worker 수 | 칸 하나가 멈출 때 영향받는 대화 | 칸마다 갱신할 때의 담당 갱신 부하 |
| 16 | 초당 약 14,468건 | 16대 | 전체의 6.25% | 초당 약 5건 |
| 4,096 | 초당 약 57건 | 4,096대 | 약 0.024% | 초당 약 1,365건 |
| 65,536 | 초당 약 3.5건 | 65,536대 | 약 0.0015% | 초당 약 21,845건 |
- 너무 적을 때(16개). worker를 17대로 늘려도 받을 칸이 없습니다. 뜨거운 대화 하나가 섞인 칸을 다른 worker로 옮기면 같은 칸의 대화 전체(전체의 1/16)가 함께 옮겨 가고 함께 다시 읽혀서, 뜨거운 대화만 떼어 내는 격리가 되지 않습니다.
- 너무 많을 때(65,536개). 칸마다 담당 기한을 따로 갱신하면 coordinator에 초당 약 2.2만 건(65,536 ÷ 3)의 쓰기가 들어옵니다. coordinator는 여러 노드의 합의로 쓰기를 확정하는 저장소라서, 메시지 경로보다 coordinator가 먼저 병목이 될 수 있습니다. 이 부하는 갱신을 worker 단위로 묶으면 칸 수와 무관해집니다. 저는 그 방식을 골랐고, 구조는 5절에서 lease를 설명한 뒤에 적습니다.
- 4,096개가 틀리는 조건. worker가 4,096대를 넘어야 하는 규모이거나, 칸 하나의 평균 약 57건에 뜨거운 대화가 겹쳐 칸 하나가 worker 한 대의 처리량을 넘는 경우입니다. 어느 쪽이든 칸을 쪼개야 합니다. 반대쪽 비용도 있습니다. worker 16대면 한 대가 256칸의 담당을 들고 있으므로, 한 대가 죽으면 256칸이 한꺼번에 담당 교체 절차(5절, 6절)를 밟습니다.
적정 개수는 칸 하나를 다시 읽는 데 걸리는 시간과 worker 한 대가 들고 있을 수 있는 칸 수를 측정해 정할 값입니다. 칸마다 갱신한다면 coordinator가 초당 처리할 수 있는 갱신 수도 함께 따져야 합니다.
worker 수도 같은 방식으로 따졌습니다. worker를 16대(설계 가정)로 두면 한 대가 칸 256개, 초당 약 14,468건을 맡습니다. 한 대가 죽으면 그 256칸이 남은 15대로 나뉘어 한 대당 약 17.1칸, 초당 약 964건이 더해집니다. 평소 사용률이 약 94%(14,468 ÷ 15,432)를 넘게 잡혀 있으면 한 대 장애가 연쇄 과부하로 이어지므로, 평소 사용률은 그보다 낮게 둬야 합니다.
5. 이전 세대 writer가 되살아나는 상황과 lease, fencing token
단일 writer 규칙은 "한 시점에 하나"가 지켜질 때만 의미가 있습니다. 그런데 담당자를 바꾸는 순간에는 둘이 동시에 존재하는 구간이 생길 수 있습니다.
worker 2가 virtual shard 17을 맡고 있다가 GC pause에 걸렸다고 해 보겠습니다. GC pause는 자바 같은 언어에서 메모리 정리 때문에 프로세스 전체가 잠시 멈추는 현상입니다. 네트워크가 잠깐 끊기거나 프로세스가 멈추는 경우도 같습니다. 담당자를 관리하는 coordinator는 worker 2에게서 응답이 없으니 죽었다고 판정하고 worker 5에게 shard 17을 넘깁니다. 잠시 뒤 worker 2가 멈춤에서 깨어납니다. worker 2는 자기가 멈춰 있었다는 사실을 모르므로, 여전히 자기가 담당자라고 믿고 번호를 매겨 로그에 쓰려고 합니다.
이런 writer를 이전 세대(epoch)의 writer, 즉 zombie writer라고 부릅니다. 세대는 담당자가 바뀔 때마다 1씩 커지는 번호이고, 자기가 교체된 줄 모르는 writer는 이미 지나간 세대의 번호를 들고 있습니다. 이 글에서는 이후 "이전 세대 writer"라고 쓰고, 지금 담당을 맡은 쪽은 "현재 writer"라고 씁니다. 이전 세대 writer와 현재 writer가 동시에 같은 대화에 번호를 매기면, 두 메시지가 같은 seq를 받거나 서로 다른 순서가 기록됩니다. 한 대화에 writer가 둘 생긴 이 상태를 split brain이라고 합니다.
아래 그림은 아무것도 막지 않을 때 이 상황이 어떻게 흘러가는지 보여 줍니다.
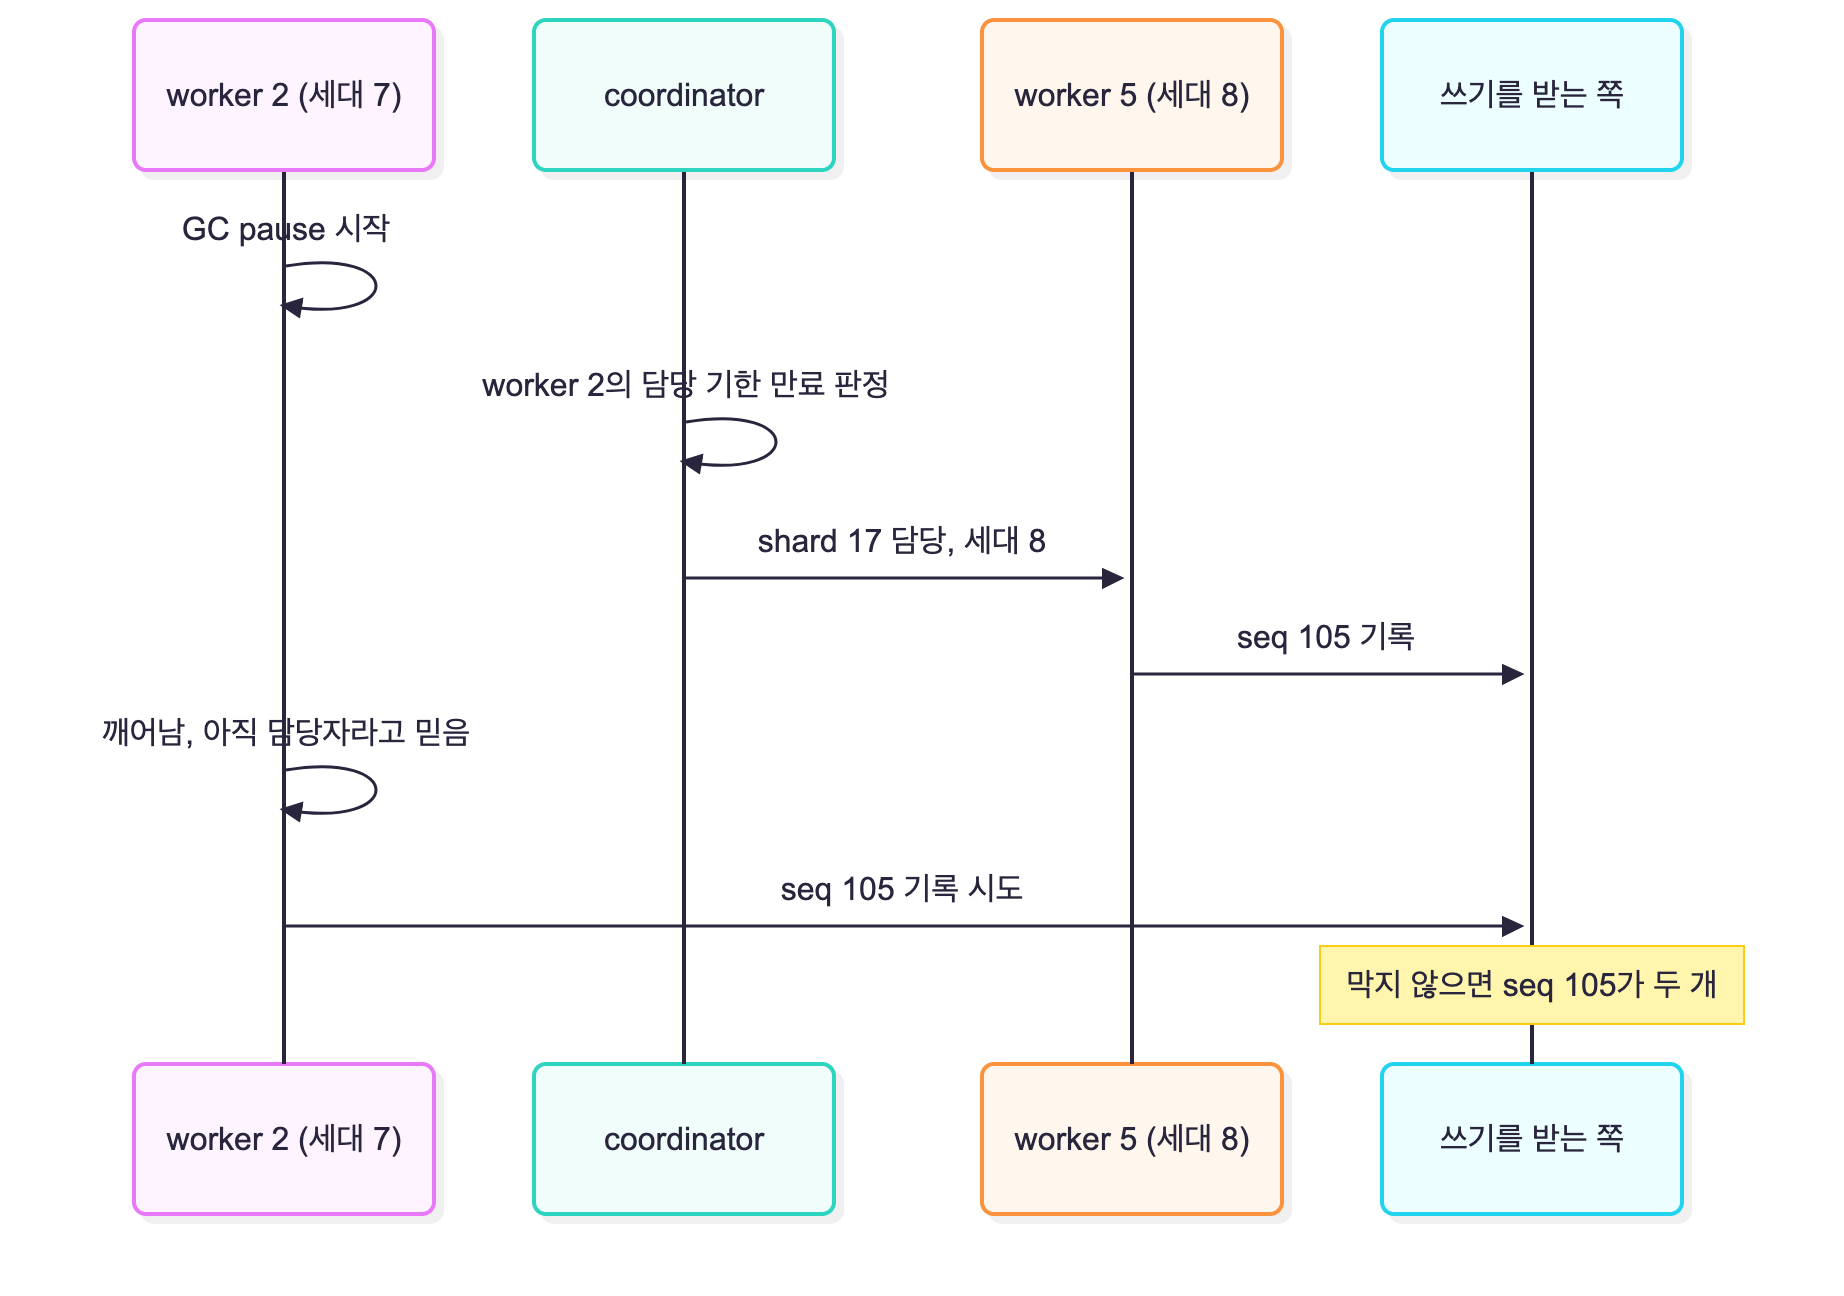
- worker 2는 멈춰 있던 동안의 일을 모릅니다. 깨어난 직후의 worker 2에게는 자기가 여전히 담당자입니다.
- coordinator의 판정은 옳습니다. 응답이 없는 worker를 오래 기다리면 그 칸의 대화 전체가 멈추기 때문입니다.
- 문제는 마지막 줄입니다. 쓰기를 받는 쪽이 세대 7과 8을 구분하지 않으면 두 기록을 모두 받습니다.
설계 문서에는 이 상황을 막는 장치로 lease와 fencing token 두 가지를 적었습니다.
- lease는 기한이 있는 담당권입니다. coordinator가 "worker 5가 shard 17을 맡는다, 단 기한 안에 갱신하지 않으면 무효"라는 형태로 줍니다. 누가 담당자인지 정하는 데 씁니다.
- fencing token은 lease를 줄 때마다 1씩 커지는 세대 번호입니다. writer는 쓰기 요청에 자기 세대 번호를 싣고, 쓰기를 받는 쪽은 지금까지 본 가장 큰 번호보다 작은 번호의 쓰기를 거부합니다.
lease만으로는 부족합니다. lease 만료는 coordinator의 시계로 판정되고, 이전 세대 writer는 자기 시계로 "아직 기한 안"이라고 믿습니다. Martin Kleppmann이 분산 락을 다룬 글(2016년)에서 같은 문제를 설명합니다. 락을 쥔 클라이언트가 GC pause로 멈춘 사이 lease가 만료되고 다른 클라이언트가 락을 얻으면, 깨어난 첫 클라이언트는 자기 lease가 끝난 줄 모르고 저장소에 씁니다. 그 글의 해법은 락 서비스가 매번 커지는 번호(fencing token)를 발급하고, 저장소가 이미 더 큰 번호의 쓰기를 처리했다면 작은 번호의 쓰기를 거부하게 하는 것입니다. lease는 누가 담당자인지 알려 줄 뿐이고, 담당자가 아닌 쪽의 쓰기를 실제로 막는 것은 쓰기를 받는 쪽의 번호 비교입니다.
lease 획득과 갱신을 조건부 쓰기로 적으면 다음과 같습니다. 세대 번호가 단조 증가하려면 이 저장소는 여러 노드의 과반수 합의로 쓰기를 확정해야 합니다. 단일 노드나 비동기 복제로 두면 네트워크가 갈라졌을 때 두 coordinator가 서로 다른 worker에게 같은 세대를 줄 수 있습니다.
# 획득: 기한이 지났을 때만, 세대를 1 올린다
UPDATE shard_lease
   SET owner = 'worker-5', epoch = epoch + 1, expires_at = now + 10s
 WHERE shard_id = 17 AND expires_at < now

# 갱신: 내가 담당이고 세대가 그대로일 때만 기한을 늘린다 (3초마다)
UPDATE shard_lease
   SET expires_at = now + 10s
 WHERE shard_id = 17 AND owner = 'worker-5' AND epoch = 8
위 코드는 칸마다 lease를 하나씩 두는 가장 단순한 형태입니다. 실제로는 갱신을 worker 단위로 묶었는데, 그 이유와 구조를 바로 아래에 적습니다.
lease 10초, 갱신 3초, worker 단위 묶음 갱신을 고른 이유
lease 값은 처음에 개념 노트에서 설계 가정으로 두었다가 따로 결정했습니다. 길이 10초, 갱신 주기 3초이고, 갱신은 칸마다 하지 않고 worker가 자기가 맡은 칸 전체를 한 번에 합니다. 세대 번호는 칸마다 둡니다.
먼저 lease가 무엇을 정하지 않는지부터 적겠습니다. 순서가 깨지지 않게 하는 것은 lease가 아니라 세대 번호입니다. 쓰기를 받는 쪽이 칸별 세대 번호를 비교하고 현재 writer가 6절의 기동 순서를 지키면, lease가 짧든 길든 같은 seq가 두 번 확정되지 않습니다. 그래서 lease 길이(L)와 갱신 주기(R)를 바꿔도 순서 보장은 그대로이고, 바뀌는 것은 다음 세 가지뿐입니다.
| lease가 정하는 것 | L 10초, R 3초일 때 |
| worker가 죽었을 때 그 칸들의 송신이 멈추는 시간 | 기한 만료 대기 약 7~10초 + 현재 writer의 세대 등록 + 다시 읽기 |
| 멀쩡한 worker가 담당을 잃는 일 | 갱신 두 번을 연속으로 놓쳐도 버팁니다. 한 번의 멈춤은 최악의 경우 약 7초까지 견딥니다 |
| 담당 기한 저장소(coordinator)의 쓰기 | worker 16대면 초당 약 5.3건(16 ÷ 3) |
송신이 멈추는 시간. worker가 마지막 갱신 직후에 죽으면 10초, 다음 갱신 직전에 죽으면 약 7초 뒤에 기한이 끝납니다. 세대 등록은 직접 재현한 환경에서 담당을 넘겨받고 수락을 다시 시작하기까지 중앙값 약 0.14~0.25초였습니다(3편에서 다룹니다). worker 16대에 4,096칸이면 한 대가 죽을 때 256칸, 대화의 6.25%가 멈춥니다. 256칸은 남은 15대가 나눠 받는데, 256 = 15 × 17 + 1이라 14대가 17칸, 한 대가 18칸을 받습니다. 한 worker가 받은 17칸을 하나씩 차례로 등록하면 마지막 칸은 약 2.5~4.3초(17 × 0.1445초, 17 × 0.2506초)를 더 기다리므로, 받은 칸은 동시에 등록합니다.
멀쩡한 worker가 담당을 잃는 일. 갱신이 제때 닿지 못하는 원인은 GC pause, 네트워크 지연, 저장소의 일시적인 지연입니다. 갱신 주기를 길이의 3분의 1 이하로 두면(R ≤ L/3) 기한 안에 갱신 기회가 세 번(3, 6, 9초) 있어서 두 번 연속 실패해도 세 번째로 살아남습니다. 멈춤 한 번이 견딜 수 있는 길이는 다음 갱신 직전에 멈추는 최악의 경우 L − R = 7초입니다. 공개된 GC 멈춤 수치로는 카카오의 발표(if(kakao) 2022)가 있습니다. 메시징 서버를 새로 만들면서 새 서버를 G1과 ZGC로 벤치마크했을 때 최대 GC 멈춤이 170ms와 1ms였습니다. 7초는 G1 값 170ms의 약 41배입니다.
담당 기한 저장소의 쓰기. 칸마다 갱신하면 쓰기가 칸 수에 비례해 4,096칸에서 초당 약 1,365건이고, 65,536칸이면 약 21,845건입니다. worker 단위로 묶으면 worker 수에 비례해 16대에서 초당 약 5.3건이고, 칸을 몇 개로 나누든 그대로입니다. 세대 번호가 하나로만 커지려면 이 저장소는 과반 합의로 쓰기를 확정해야 하므로, 쓰기가 칸 수를 따라 늘지 않게 하는 것이 묶음 갱신의 목적입니다.
묶음 갱신에서는 lease와 세대 번호를 서로 다른 행에 둡니다. lease는 worker마다 한 행이고, 담당과 세대 번호는 칸마다 한 행입니다.
worker_lease(worker_id, worker_gen, expires_at)   # 3초마다 이 행 하나만 갱신
shard_owner(shard_id, worker_id, worker_gen, epoch) # 담당이 바뀔 때만 갱신. epoch가 세대 번호
칸 s의 담당 = shard_owner[s]의 worker이고, worker_gen이 같고, 그 worker의 lease가 기한 안

# 갱신: 3초마다 한 문장. 기한이 이미 지났으면 되살리지 않는다
UPDATE worker_lease SET expires_at = now + 10s
 WHERE worker_id = 'worker-2' AND worker_gen = 41 AND expires_at > now

# worker 2가 죽은 뒤: worker 5가 자기 몫 17칸을 가져가며 칸마다 세대를 1씩 올린다
UPDATE shard_owner
   SET worker_id = 'worker-5', worker_gen = 17, epoch = epoch + 1
 WHERE shard_id IN (:받은 17칸) AND 이전 담당 worker의 lease가 끝났다
RETURNING shard_id, epoch         # 칸마다 새 세대로 동시에 기동(6절 순서)
worker_gen은 worker가 lease를 새로 얻을 때마다 커지는 값입니다. 이것이 없으면 worker 2가 담당을 잃었다가 같은 이름으로 다시 lease를 얻었을 때, 아직 아무도 가져가지 않은 칸의 옛 담당 행이 세대를 올리지 않은 채 다시 유효해 보입니다.
세대 번호를 worker가 아니라 칸마다 두는 데에는 이유가 있습니다. 쓰기를 받는 쪽은 칸 단위로 "이 칸에서 지금까지 본 가장 큰 세대"와 비교합니다. 그리고 죽은 worker의 256칸은 15대로 흩어집니다. 칸 17은 worker 5가, 칸 42는 worker 6이 받는데 두 worker의 번호는 서로 관계가 없어서, worker 번호로는 "이전 담당보다 크다"는 비교가 성립하지 않습니다. 칸마다 세대를 두면 각 칸 안에서만 비교하므로 이 문제가 없습니다.
묶음 갱신의 대가도 적어 둡니다.
- 한 worker의 갱신 실패가 256칸을 한꺼번에 놓게 만듭니다. 칸마다 갱신하면 요청 하나가 늦어도 그 칸 하나만 위험합니다. 다만 원인이 GC pause나 worker 쪽 네트워크라면 칸마다 갱신해도 256칸이 함께 실패합니다. 차이는 요청 하나가 따로 유실되는 경우에만 나고, 그 경우는 R ≤ L/3이 두 번까지 흡수합니다.
- 일부 칸만 옮기는 재조정에는 별도 절차가 필요합니다. worker를 늘리거나 뜨거운 칸을 떼어 낼 때는 worker가 살아 있으므로 기한 만료로 옮길 수 없습니다. coordinator가 그 칸의 담당 행 하나를 조건부로 바꾸면서 세대를 올리고, 새 worker가 기동 순서를 밟습니다. 이전 worker는 다음 갱신(최대 3초) 때 함께 읽는 자기 칸 목록에서 그 칸이 빠진 것을 보고 수락을 멈춥니다. 그 전에 보낸 쓰기는 세대 번호에서 거부됩니다.
이 결정이 틀리는 조건도 있습니다.
- GC pause가 약 7초를 넘는 환경. 전체 GC가 수 초씩 걸리는 큰 힙이나 스왑이 일어나는 서버에서는 멈출 때마다 대화의 6.25%가 약 10초씩 멈추고 칸이 worker 사이를 오갑니다. 순서는 세대 번호가 지키지만, 이때는 lease를 늘리기보다 GC 멈춤을 줄이는 것이 먼저입니다.
- 담당 기한 저장소 장애. 저장소가 과반을 잃으면 갱신이 모두 실패합니다. 칸마다 갱신해도 같습니다. 저는 갱신이 오류로 끝났을 때는 수락을 멈추지 않게 했습니다(갱신 결과가 "기한이 이미 끝났다"로 돌아왔을 때만 멈춥니다). 저장소가 죽어 있으면 새 담당자를 세울 수도 없으니 두 writer가 겹칠 일이 없기 때문입니다. 대신 그동안 worker가 죽으면 그 칸들은 저장소가 돌아올 때까지 멈춥니다. 저장소가 돌아온 직후에는 모든 lease가 만료돼 보여 살아 있는 worker들의 4,096칸을 서로 가져가는 경쟁이 생길 수 있어서, 복구 때 모든 lease를 한 번 연장한 뒤 가져가기를 허용하는 유예가 필요합니다. 이 부분은 아직 재 보지 않았습니다.
고르지 않은 대안 두 가지도 남겨 둡니다.
| 대안 | 저장소 쓰기(4,096칸, worker 16대) | 장애 때 송신 멈춤 | 고르지 않은 이유 |
| 칸마다 10초, 3초로 갱신 | 초당 약 1,365건 | 약 7~10초 + 등록 + 다시 읽기 | 쓰기가 칸 수에 비례합니다. 얻는 것(요청 하나 유실의 영향이 한 칸)은 R ≤ L/3이 이미 흡수합니다 |
| 칸마다 30초로 갱신 (설계 문서의 처음 값) | 초당 약 137건 (4,096 ÷ 30) | 최대 30초 이상. R ≤ L/3을 지키면 60~90초 | lease는 갱신 주기보다 길어야 해서 최대 멈춤이 30초 밑으로 내려가지 않습니다. 쓰기를 줄이는 목적은 묶음 갱신이 lease를 늘리지 않고 이룹니다 |
7초를 넘는 멈춤은 드물지만, 네트워크 단절은 이 길이를 넘을 수 있어 0은 아닙니다. 그래서 세대 번호는 드문 경우를 위한 장치이고, 평소에는 실행되지 않으므로 장애 주입 테스트로 따로 확인해야 합니다(8절). 10초와 3초도 운영에서 잰 멈춤 분포와 저장소의 갱신 처리 p99가 "기한 안에 갱신 재시도 두 번"을 넣지 못하면 다시 정할 값입니다.
설계 문서를 처음 썼을 때 저는 여기까지만 적고 한 가지를 비워 두었습니다.
어느 계층이 낮은 epoch의 append를 거부하는지는 구현 전에 반드시 명시해야 한다. 이름만 fencing이라고 붙이고 검증 지점이 없으면 split brain을 막지 못한다.
이 빈칸을 채운 과정을 다음 절에 적습니다.
6. 이전 세대 writer의 쓰기를 누가 거부하는가
세 가지 일을 나누어 보기
처음에는 "fencing"이라는 말 하나로 여러 일을 묶어 생각하고 있었습니다. 나눠 보니 서로 다른 일 세 가지였습니다.
| 하는 일 | 누가 하는가 | 뺄 수 있는가 |
| 담당자 결정("worker 5가 shard 17을 맡는다") | coordinator가 주는 lease | 뺄 수 없습니다 |
| 이전 세대 writer 차단(그 writer의 쓰기를 거부) | 쓰기를 받는 쪽의 세대 번호 비교 | 뺄 수 없습니다 |
| 자기 검사("내 lease가 아직 유효한가") | Shard 프로세스 자신 | 뺄 수 있습니다 |
자기 검사는 Shard가 번호를 매기기 전에 자기 lease가 아직 살아 있는지 스스로 확인하는 코드입니다. 처음에는 이것도 방어 장치 중 하나로 생각했는데, 결론은 이 코드를 방어 장치로 두지 않는 것이었습니다.
자기 검사가 막지 못하는 경우
자기 검사는 자기 상태를 정확히 알고 있는 프로세스만 막습니다. GC pause에서 막 깨어난 worker 2는 lease가 만료됐다는 사실을 아직 모르므로 자기 검사를 통과합니다. worker의 시계가 느리게 가면 더 오래 통과합니다. 검사를 통과한 직후에 다시 멈췄다가 깨어나 쓰는 경우도 막지 못합니다. lease 구현을 잘못해서가 아니라, 판정하는 쪽과 판정받는 쪽이 같은 프로세스라서 생기는 한계입니다.
쓰기를 받는 쪽이 세대 번호로 거부하는 방식은 다릅니다. worker 2가 자기 상태를 아무리 잘못 알고 있어도 상관없습니다. worker 2는 자기가 담당자라고 확신한 채로 쓰기를 시도해도, 이전 세대의 쓰기라면 쓰기를 받는 쪽에서 거부됩니다. 거부를 받았다는 사실만으로 lease를 잃었다고 단정하지 않고, 담당 여부는 다시 확인합니다. 판정이 쓰기가 실제로 일어나는 자리에서 이뤄집니다.
거부하는 위치 두 곳
그러면 "쓰기를 받는 쪽"은 어디일까요. 설계 문서의 Shard는 로그 저장소에만 쓰므로, 처음에는 로그 저장소가 거부하는 것으로 정했습니다. 그런데 이것을 구체적인 로그 저장소에 대입해 보다가, 로그 저장소가 이전 세대를 막게 하는 데 드는 조건과 비용이 생각보다 크다는 것을 알게 됐습니다. 그래서 두 위치를 함께 놓고 비교했고, 재현과 측정을 거쳐 로그 저장소가 거부하는 쪽을 기본으로 정했습니다. 이 절은 두 위치를 비교한 과정이고, 정한 내용은 절 끝에 적었습니다.
이전 세대 writer의 쓰기는 로그 저장소가 세대 번호로 거부하거나, 저장 단계가 세대 번호를 검사해 거부합니다. 저장 단계는 로그를 읽어 메시지 저장소에 옮겨 쓰는 쪽(Persist Worker)입니다.
아래 그림은 두 위치에서 이전 세대의 기록이 어디까지 가는지 비교합니다.
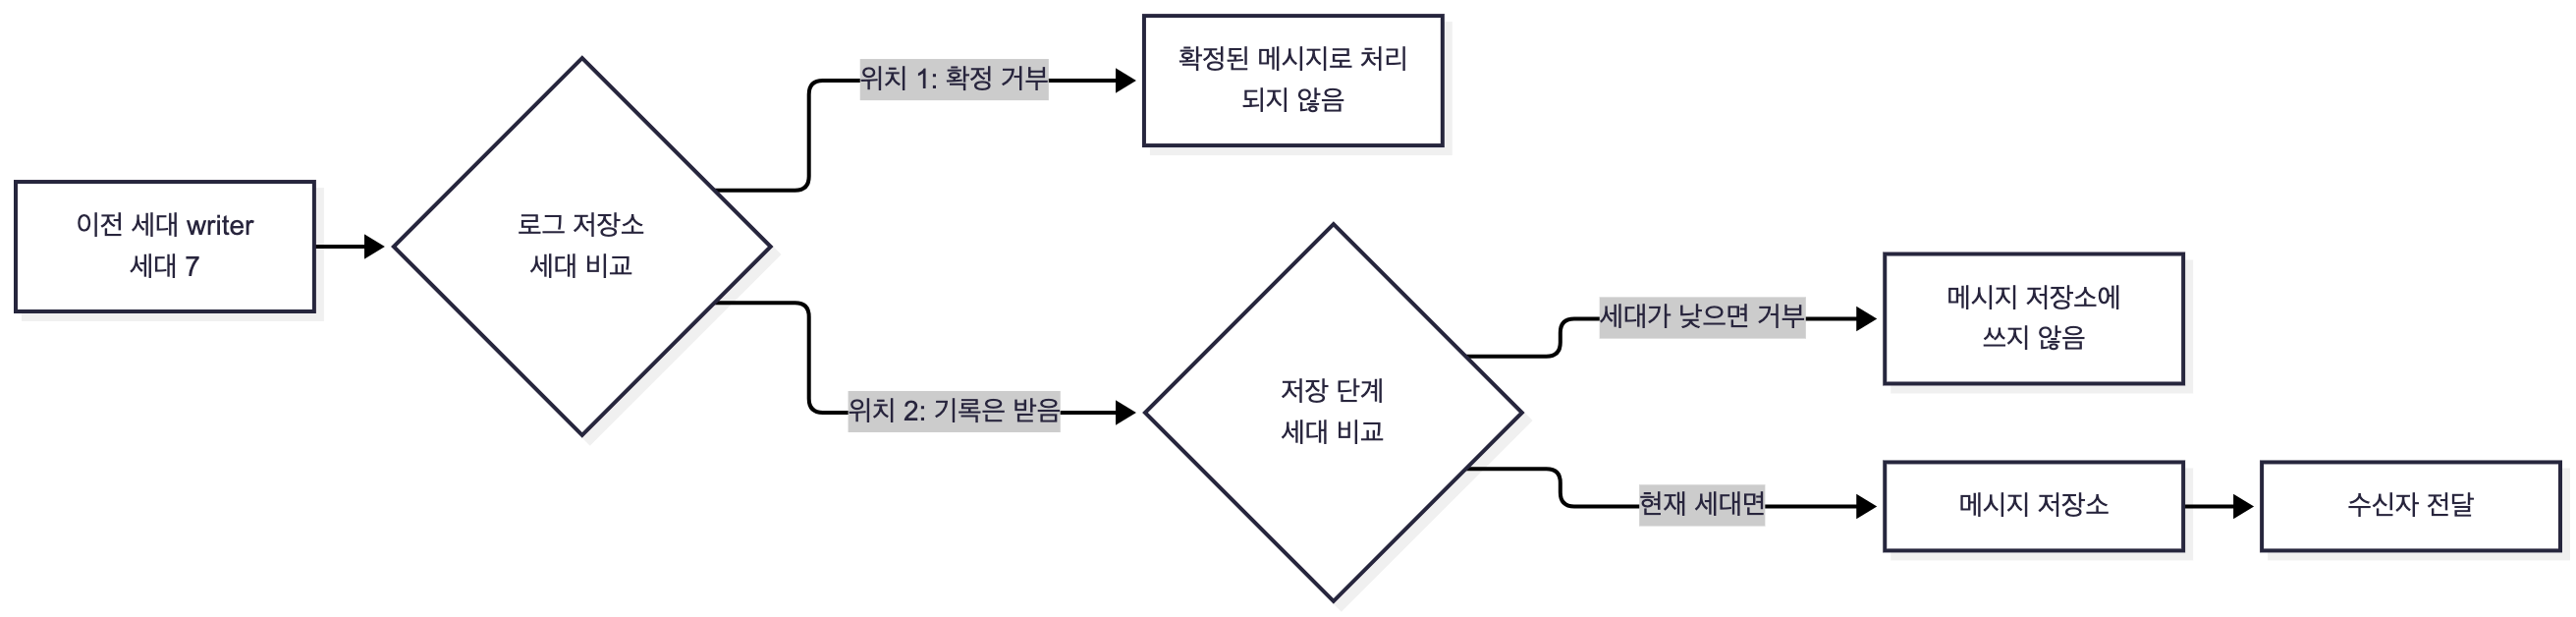
- 위치 1에서는 이전 세대의 기록이 확정된 메시지로 인정되지 않습니다. 로그 제품에 따라 중단된 기록의 흔적은 남을 수 있습니다.
- 위치 2에서는 이전 세대의 기록이 로그에는 남고, 저장 단계에서 걸러집니다. 수신자 전달은 설계상 저장이 성공한 뒤에 시작하므로, 저장에서 거부된 기록은 전달되지 않습니다.
- 어느 위치든 사용자에게 보이는 결과(메시지 저장소와 전달)에는 이전 세대의 기록이 들어가지 않아야 한다는 조건은 같습니다.
두 위치의 차이를 항목별로 정리했습니다.
위치 1. 로그 저장소가 세대 번호로 거부한다
- 근거. 이전 세대 writer의 쓰기가 확정된 메시지로 처리되지 않습니다. 다만 Kafka처럼 중단된 기록이 물리 로그에 남는 제품에서는 소비자가 그 기록을 건너뛰어야 합니다.
- 조건. 로그 저장소가 "같은 칸의 이전 세대"를 알아볼 수 있어야 합니다. 그래서 세대 번호를 virtual shard 단위로 묶어야 합니다. worker 단위로 묶으면 로그 저장소는 worker 2와 worker 5를 서로 관계없는 두 쓰기 주체로 보고 둘 다 받습니다. 이름만 fencing이고 아무것도 막지 않는 상태입니다.
- 트레이드오프와 예상되는 문제점. 로그 저장소에 따라, 이전 세대를 거부하는 기능을 쓰면 거부된 기록이 로그에 흔적으로 남고, 로그를 읽는 모든 쪽이 그 흔적을 건너뛰도록 설정해야 하는 경우가 있습니다. 한 곳이라도 설정을 빠뜨리면 같은 seq가 두 번 저장되거나 전달됩니다. 기록을 모아 확정하는 주기만큼 전달이 늦어지는 비용도 붙습니다. 예를 들어 그 주기가 100ms(설계 가정)라면 전달 p99 1초 예산의 10%를 씁니다.
- 장애. 세대 등록을 처리하는 쪽이 느리면, 현재 writer가 세대를 등록하지 못해 그 칸의 대화 전체가 수락을 시작하지 못합니다.
위치 2. 저장 단계가 세대 번호를 검사해 거부한다
- 근거. fencing token의 원래 모양과 같습니다. 보호할 대상(사용자가 보는 대화 기록)을 쓰는 곳이 번호를 검사합니다. 로그 저장소에 특별한 기능이 필요 없습니다.
- 트레이드오프. 이전 세대의 기록이 로그에 남습니다. 저장 단계가 칸마다 현재 세대를 알아야 하고, 모든 저장 쓰기가 조건부 쓰기가 됩니다. 피크 초당 약 231,480건 전부에 조건부 쓰기를 걸었을 때의 처리량은 쓰는 저장소에 따라 크게 다르므로, 측정해서 정할 값입니다.
- 반례. 저장 단계를 거치지 않고 로그를 직접 읽는 쪽(예: 분석 파이프라인)은 이전 세대의 기록을 그대로 봅니다. 이런 소비자가 있으면 그쪽도 같은 검사를 해야 합니다.
처음에는 위치 2를 "저장 단계가 담당 테이블(lease를 기록한 테이블)에서 그 칸의 현재 세대를 읽고, 그보다 낮은 기록을 쓰지 않는다"로 적어 두었습니다. 이 조건부 쓰기를 관계형 데이터베이스 하나와 로그 하나로 재현해 보니, 이전 세대의 기록은 걸러졌지만 걸러야 할 것만 거르지는 않았습니다. 위치 2가 성립하려면 아래 조건 세 가지가 모두 필요했습니다.
조건 1. 비교 기준을 담당 테이블의 현재 세대가 아니라 로그에 기록된 순서에 묶습니다. 담당 테이블과 비교하면 "기록을 보낸 시점"이 아니라 "저장하는 시점"의 담당자와 비교하게 됩니다. 재현에서 이전 담당자(세대 5)가 lease가 유효할 때 101, 102를 로그에 기록하고 사용자에게 성공으로 응답했는데, 저장 단계가 밀려 있어 담당이 세대 6으로 넘어간 뒤에야 두 기록을 처리했습니다. 두 기록은 모두 거부됐고, 성공 응답을 받은 메시지 두 개가 대화에서 사라졌습니다. 그래서 저장 단계는 "지금까지 로그에서 본 가장 큰 세대"와 비교하고, 새 writer는 담당을 넘겨받은 직후 로그에 교체 표시 레코드를 씁니다. 저장 단계는 교체 표시를 만났을 때만 기준 세대를 올립니다. 이렇게 바꾼 재현에서는 교체 표시보다 앞에 기록된 이전 세대의 레코드가 교체 뒤에 처리돼도 저장됐고, 교체 표시 뒤에 들어온 이전 세대의 레코드만 거부됐습니다. Martin Kleppmann이 설명한 fencing token의 모양(저장소가 본 가장 큰 번호보다 작으면 거부)과 같습니다.
조건 2. 세대 검사와 담당 교체가 경쟁하지 않도록, 저장 단계는 비교하는 행을 잠급니다. 기본 격리 수준(READ COMMITTED)에서 조건부 쓰기의 세대 검사는 문장 시작 시점의 스냅숏을 읽을 뿐 비교하는 행을 잠그지 않습니다. 그래서 이전 세대의 기록이 아직 커밋되기 전에 새 writer가 담당을 교체하고 저장소의 마지막 seq를 읽으면, 새 writer는 그 기록을 보지 못하고 같은 seq를 다시 매깁니다. 커밋된 이전 세대의 기록이 그 자리를 차지하고, 새 writer의 기록은 같은 키 충돌로 조용히 버려집니다. 처음 방식대로 담당 테이블의 현재 세대와 비교하면서, 인위적인 지연 없이 이 경쟁을 20,000번 반복했습니다. 디스크 동기 쓰기(fsync)를 켠 조건에서 139번(이전 세대 기록이 저장된 19,832번 중 0.70%) 이전 세대의 기록이 그 자리를 차지했고, 139번 모두 새 writer의 기록이 버려졌습니다. 비교하는 담당 행에 공유 잠금(FOR SHARE)을 걸자 같은 20,000번에서 0번이었습니다. 잠금을 걸면 새 writer의 담당 교체가 진행 중인 저장의 커밋을 기다리기 때문입니다.
조건 1의 기준을 쓰면 비교하는 행은 담당 행이 아니라 저장소가 지금까지 본 가장 큰 세대를 담은 행입니다. 저장 단계는 이 행을 갱신하면서 비교하므로 이미 그 행을 잠그고 있고, 같은 경쟁 20,000번에서 0번이었습니다. 같은 비교에서 잠금만 뺀 대조군은 3번이었고, 이전 세대 기록의 문장 시작부터 커밋까지 걸리는 구간을 5ms 넓혀 2,000번 반복하면 이전 세대 기록이 저장된 1,994번 중 1,867번이었습니다. 그래서 조건 1과 2는 함께 쓰면 잠금을 따로 더하지 않아도 성립합니다.
조건 3. 사용자에게 보내는 성공 응답(ACCEPTED)을 로그 기록 성공이 아니라 저장 결과 뒤로 옮깁니다. 이전 세대 writer의 기록은 로그에는 들어갑니다. 재현에서 담당이 넘어간 뒤 깨어난 이전 writer가 세 번 기록했고, 로그는 세 번 모두 기록 성공을 돌려줬습니다. 저장 단계는 세 기록을 모두 거부했지만 그 결과가 이전 writer에게 돌아가는 경로가 없었습니다. 로그 기록 성공만 보고 응답하면 사용자 세 명은 성공 응답을 받았는데 메시지는 대화에 없습니다. 성공 응답을 받은 메시지는 복구할 수 있어야 한다는 I1과 어긋나므로, writer는 저장 결과를 받고 나서 응답해야 합니다. 이 조건은 조건 1, 2를 어떻게 바꿔도 남습니다. 대신 저장 단계의 처리 지연이 수락 응답 지연에 더해집니다. 같은 재현 환경에서 초당 1,000건을 보내며 재 보니(디스크 동기 쓰기를 끈 조건, 3회 반복의 중앙값), 로그 기록 성공까지는 중앙값 0.46ms였고 저장 완료까지는 중앙값 0.83ms, p99 146.9ms였습니다. 저장 완료 시각은 writer에게 결과를 알리는 경로를 뺀 값이라 실제 수락 지연의 하한입니다. 중앙값은 0.4ms 정도 늘 뿐이지만 꼬리가 깁니다. 저장 단계 하나가 기록을 순서대로 저장하므로, 문장 하나가 멈추면(20ms를 넘는 멈춤이 10초에 0~45번, 가장 긴 것은 213ms) 그 뒤의 기록이 모두 줄을 서서 기다립니다. 저장 단계의 처리량을 넘는 부하(초당 4,000건)에서는 저장 완료까지 중앙값이 수 초로 늘었습니다.
조건 세 가지를 반영한 저장 단계는 다음과 같습니다(의사 코드).
# 저장 단계: 로그에서 본 가장 큰 세대보다 낮은 기록은 쓰지 않는다
on_record(rec):
    shard = virtual_shard_of(rec.conversation_id)
    in_transaction:
        fence = lock_for_update(fence_row(shard))      # 조건 2: 비교하는 행을 잠근다(이 행에 저장소가 본 가장 큰 세대가 있다)
        if rec.is_takeover_marker:                     # 새 writer가 담당을 넘겨받으며 쓴 교체 표시
            fence.max_epoch = max(fence.max_epoch, rec.epoch)
            return
        if rec.epoch < fence.max_epoch: result = REJECTED   # 조건 1: 교체 표시 뒤의 이전 세대 기록
        else: result = insert_if_absent(key = (rec.conversation_id, rec.seq), rec)
    notify_writer(rec, result)                         # 조건 3: writer는 이 결과를 받고 ACCEPTED
직접 재현해 본 결과는 3편과 실험 저장소(https://github.com/iohyeon/chat-message-ordering)에 있습니다. 이 절의 세 재현은 저장소의 results/Q5.md에, 비교하는 행의 잠금과 수락 지연 측정은 results/Q7.md에 정리되어 있고, 20,000번 반복한 원 데이터는 results/data/q5_race_soak.csv입니다. 재현은 로컬 컨테이너 한 벌에서 대화 하나로 돌린 것이라, 139번은 그 환경에서의 빈도입니다. 운영에서 이 경쟁이 얼마나 자주 생기는지는 측정해서 정할 값입니다.
두 위치 모두 쓰는 방법도 있습니다. 로그에서 확정된 메시지만 읽도록 하면서 저장 단계에서 한 번 더 걸러, 설정 누락 같은 실수를 막습니다. 대신 두 비용을 모두 냅니다. 어느 위치를 고를지 정하려고 두 방식의 비용(로그 쪽 확정 주기에 따른 전달 지연, 저장 쪽 조건부 쓰기의 처리량과 저장 결과를 기다리는 만큼 늘어나는 수락 지연)을 재어 봤고, 두 위치를 함께 둔 경우도 재현해 봤습니다.
정한 것: 로그 저장소가 세대 번호로 거부하는 쪽을 기본으로 두고, 저장 단계는 같은 순번의 두 번째 저장만 막습니다. 저장 단계는 논리적으로 (conversation_id, conversation_seq)가 같은 기록의 중복을 막고, 세대 번호는 비교하지 않습니다. 실제 이력 테이블은 bucket으로 나뉘므로 물리 키에는 bucket도 포함됩니다. 이유는 세 가지입니다.
- 위치 2는 위의 세 조건이 모두 있어야 성립하고, 하나라도 빠지면 성공 응답을 받은 메시지를 잃었습니다. 조건 3 때문에 수락 지연의 꼬리도 저장 단계 하나의 멈춤을 그대로 따라갑니다.
- 두 위치를 함께 두면 지켜 주는 것 없이 잃는 것만 생겼습니다. 담당이 넘어간 직후, 새 writer가 로그 저장소에 세대를 등록하기 전에 이전 writer가 정상적으로 확정한 기록은 새 writer도 이어 받는 올바른 메시지입니다. 그런데 저장 단계가 담당 테이블의 현재 세대와 비교하면 이 기록이 늘 거부됐습니다. 로그에서 본 가장 큰 세대와 비교하면 잃은 것은 없었지만, 세대를 비교하지 않고 같은 순번만 막은 경우와 결과가 같아 더해 준 것이 없었습니다.
- 로그 저장소 쪽은 확정 주기를 짧게 두면 수락 지연이 목표 안에 들어왔습니다.
그 대신 로그 저장소 쪽 조건(세대 번호를 virtual shard 단위로 묶기, 로그를 읽는 모든 쪽이 거부된 기록의 흔적을 건너뛰기, 현재 writer의 기동 순서)은 하나도 빠뜨리면 안 됩니다. 저장 단계가 세대를 보지 않으므로, 흔적을 건너뛰는 설정을 빠뜨린 소비자가 생기면 걸러 줄 곳이 없습니다. 제품을 넣었을 때의 설정 이름과 측정 숫자는 3편에 적었습니다.
자기 검사를 빼도 순서가 깨지지 않는 이유
어느 위치에서 거부하든, 자기 검사를 방어 장치로 두지 않아도 되는 이유는 I1입니다. ACCEPTED는 기록이 확정된 뒤에만 나갑니다. 로그 저장소가 거부하는 경우로 이전 세대 writer의 실행 경로를 따라가 보면 이렇습니다.
이전 세대 writer의 실행 경로

  명령 수신 → 멤버십 검사 → seq 105 부여 → 로그 기록 시도
                                              ↓
                                 거부 (세대 번호가 낮음)
                                              ↓
                                 기록 안 됨 → ACCEPTED 안 나감
                                              ↓
                  클라이언트는 응답을 못 받음 → 같은 client_message_id로 재시도
                                              ↓
                              현재 writer가 처리하고 정상적인 seq 부여
이전 세대 writer가 메모리 안에서 105번을 매긴 것만으로는 아무 일도 일어나지 않습니다. 그 번호가 의미를 가지려면 사용자에게 보이는 결과에 들어가야 하는데, 들어가는 입구에서 세대 번호가 막고 있습니다. 재시도는 같은 client_message_id를 쓰므로 현재 writer가 처리해도 메시지가 두 개가 되지 않습니다.
로그 저장소가 거부하는 경우 seq 카운터도 어긋나지 않습니다. 현재 writer는 로그를 다시 읽어(replay) 마지막 seq를 복원합니다. 이전 세대 writer의 105번 기록이 거부됐다면 로그에 없으므로 현재 writer도 105번부터 씁니다. 105번이 교체 전에 이미 기록됐다면 로그에 있으므로 현재 writer는 106번부터 씁니다. 두 경우 모두 확정된 번호는 겹치지 않습니다.
대신 지켜야 하는 규칙
세대 번호로 막을 수 있는 것은 로그를 거쳐 가는 기록뿐입니다. Shard가 로그를 거치지 않고 직접 하는 일은 막지 못합니다.
세대 번호가 막는 것         로그 기록과, 로그를 읽어 만드는 결과

세대 번호가 못 막는 것      Shard가 직접 하는 캐시 갱신
                           기록 확정 전에 클라이언트에 먼저 보내는 성공 응답
                           접속 상태 이벤트 발행
                           Metadata DB 직접 쓰기
이전 세대 writer가 이 중 하나라도 하면, 로그에는 아무것도 남지 않았는데 바깥에는 흔적이 남습니다. 예를 들어 이전 세대 writer가 강퇴 명령을 처리하면서 캐시에 "강퇴 완료"를 먼저 쓰고 로그 기록은 거부되면, 캐시에는 u2가 강퇴된 것으로 보이는데 로그와 Metadata DB에는 u2가 여전히 참여자입니다. 그래서 설계 규칙을 하나 정했습니다.
Conversation Shard는 로그 기록으로 게이트되지 않는 부수효과를 만들지 않는다.
"게이트된다"는 말은 로그 기록이 확정되어야만 그 일이 일어난다는 뜻입니다. 아래 두 코드의 차이가 이 규칙의 전부입니다.
틀린 코드                           맞는 코드
cache.put(member_removed)          append_to_log(KICK u2, seq)    # 거부되면 여기서 끝
append_to_log(KICK u2, seq)        (Projection이 로그를 읽고 cache와 Metadata DB에 반영)
맞는 코드에서 캐시와 Metadata DB를 고치는 것은 Shard가 아니라 로그를 읽는 Projection입니다. 설계 문서의 멤버십 경로가 이미 이렇게 되어 있어서, Shard는 Metadata DB를 직접 쓰지 않습니다. 저장 단계에서 거부하는 방식을 쓴다면 Projection도 로그를 읽는 쪽이므로 같은 세대 검사를 해야 합니다.
이 규칙에는 비용이 있습니다. 캐시 갱신, 멤버십 반영, 알림이 모두 기록 확정 뒤로 밀려 그만큼 늦게 보입니다. 그리고 이 규칙은 코드 리뷰로만 지켜집니다. 새 기능이 Shard 안에 외부 호출을 넣을 때마다 어길 위험이 있습니다. 그래도 규칙을 지키면 자기 검사는 쓸데없는 기록 시도를 조금 줄여 주는 최적화 정도의 의미만 남습니다. 규칙을 지키지 않으면 자기 검사가 마지막 방어 수단이 되는데, 앞에서 본 대로 그 방어는 믿을 수 없습니다. 그래서 자기 검사를 남겨 두는 대신 이 규칙을 지키는 쪽을 택했습니다.
lease는 그대로 둡니다. 세대 번호를 검사하는 쪽은 이전 세대를 거부할 수는 있어도, 누구를 담당자로 세울지는 정해 주지 않기 때문입니다.
현재 writer의 기동 순서
세대 번호로 막더라도 틈이 하나 남습니다. 이전 세대 writer의 lease가 만료된 시각과, 현재 writer가 새 세대 번호를 등록한 시각 사이입니다. 새 세대가 등록되기 전까지는 쓰기를 받는 쪽이 이전 세대를 거부할 근거가 없습니다.
그래서 현재 writer가 어떤 순서로 일을 시작하는지가 설계에서 정해야 할 사항이 됩니다. 아래 그림은 제가 정한 기동 순서입니다.
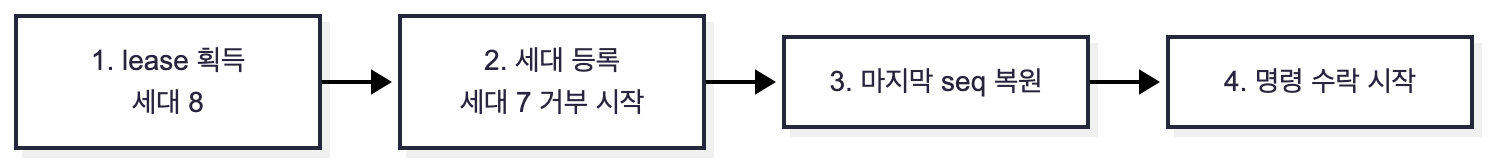
- 세대 등록은 쓰기를 받는 쪽(로그 저장소나 저장 단계)이 "이 칸의 현재 세대는 8"이라고 알게 하는 일입니다. 이 뒤로는 세대 7의 쓰기가 거부됩니다.
- replay는 등록 뒤에 합니다. 등록 전에 replay를 끝내면, 그 사이에 이전 세대 writer가 확정한 기록을 현재 writer가 모른 채 같은 seq를 다시 붙일 수 있습니다.
- 수락은 맨 마지막입니다. 등록 전에 수락을 시작하면 짧은 구간이지만 두 writer가 동시에 기록할 수 있습니다.
3단계에서 마지막 seq를 어디서 읽는지는 거부하는 위치에 따라 다릅니다. 로그 저장소가 거부하는 방식에서는 로그에 확정된 기록만 있으므로 로그를 replay합니다. 저장 단계가 거부하는 방식에서는 마지막 seq를 로그 replay가 아니라 저장소에서 읽습니다. 이 방식의 로그에는 나중에 거부될 기록까지 들어 있기 때문입니다. 재현에서 새 writer가 로그 끝을 읽어 마지막 seq를 102로 보고 103부터 매기자, 로그에 있던 101, 102는 저장 단계에서 거부되어 저장소에는 100 다음이 103이었습니다. 101, 102 자리가 빈 것입니다. 그래서 저장 단계 방식의 2단계 "세대 등록"은 교체 표시 레코드를 로그에 쓰는 일이고, 3단계는 저장 단계가 그 교체 표시를 처리한 것을 확인한 뒤 저장소에서 마지막 seq를 읽는 일입니다. 저장 단계가 밀려 있으면 그만큼 기다리므로 멈추는 시간이 늘어납니다.
replay는 매번 로그를 처음부터 읽지 않도록, 칸마다 대화별 마지막 seq를 주기적으로 저장해 둔 지점(checkpoint)부터 읽습니다. 아래는 두 대안의 복구 순서를 비교하는 의사코드이며, 채택한 방식과 대안을 나란히 적은 것입니다.
on_acquire(shard, epoch):                        # 로그 저장소가 거부하는 방식
    register_epoch(shard, epoch)                 # 쓰기를 받는 쪽에 세대 등록, 이전 세대 차단
    cp = load_checkpoint(shard)                  # conversation_id → last_seq
    for rec in read_log(shard, from = cp.position):
        cp.last_seq[rec.cid] = max(cp.last_seq[rec.cid], rec.seq)
    start_accepting(shard)

on_acquire(shard, epoch):                        # 저장 단계가 거부하는 방식
    pos = append_takeover_marker(shard, epoch)   # 교체 표시 기록, 이 뒤의 이전 세대 기록은 거부됨
    wait_until_store_processed(shard, pos)       # 저장 단계가 교체 표시까지 처리할 때까지 대기
    last_seq = read_last_seq_from_store(shard)   # 로그 replay가 아니라 저장소에서 읽음
    start_accepting(shard)
GC pause 12초 타임라인
기동 순서가 실제로 무엇을 막는지, lease 10초, 갱신 3초일 때 worker 2가 12초 동안 멈추는 경우로 따라가 봤습니다. 세대 등록에 0.5초가 걸린다고 둔 것은 설계 가정입니다.
t=0.0   worker 2 lease 갱신 성공 (세대 7), 곧바로 GC pause 시작
t=10.0  coordinator: shard 17 lease 만료
t=10.1  worker 5가 lease 획득 (세대 8)
t=10.6  worker 5 세대 8 등록 완료 → 이후 세대 7의 쓰기는 거부
t=10.7  worker 5 replay 완료, 마지막 seq 104 확인, 명령 수락 시작
t=11.0  worker 5가 seq 105 기록
t=12.0  worker 2 깨어나 seq 105 기록 시도 → 거부 (세대 7 < 8)
        worker 2는 ACCEPTED를 보내지 못하고, 클라이언트는 같은 client_message_id로 재시도
같은 입력에서 세대 등록이 3초 걸려 t=13.1에 끝나면, t=12.0의 worker 2 기록은 막히지 않습니다. 이때 결과는 기동 순서에 따라 갈립니다.
세대 등록 3초, 순서를 지킨 경우
t=12.0  worker 2가 seq 105 기록 → 아직 세대 7이 유효하므로 정상 기록
t=13.1  worker 5 세대 8 등록 완료
t=13.2  worker 5 replay에서 worker 2의 seq 105를 봄 → 106부터 부여
        결과: 105와 106이 한 번씩, 충돌 없음

세대 등록 3초, 순서를 뒤집은 경우 (replay와 수락을 등록보다 먼저)
t=10.2  worker 5 replay 완료, 마지막 seq 104 → 수락 시작
t=11.0  worker 5가 seq 105 기록
t=12.0  worker 2가 seq 105 기록 → 아직 세대 7이 유효하므로 정상 기록
        결과: seq 105가 서로 다른 두 메시지에 붙음
세대 등록이 느리면 이전 세대 writer를 막지 못하는 구간이 생깁니다. 그래도 기동 순서를 지키면 그 기록은 정상 기록으로 남고 현재 writer가 replay에서 알아보므로 순서가 깨지지 않습니다. 순서를 뒤집었을 때만 seq 105가 두 번 나옵니다. 이 타임라인을 그려 보고 나서, 기동 순서를 "권장"이 아니라 규칙으로 적었습니다.
장애 조치 동안 멈추는 시간
기동 순서를 지키는 대가는 멈추는 시간입니다. worker 하나가 죽으면 그 칸의 대화는 다음 시간 동안 메시지를 보내지 못합니다.
송신 공백 = lease 만료 대기 + 세대 등록 + replay
          = (7~10초) + (재현 약 0.14~0.25초, 타임라인에서는 0.5초로 둠) + (checkpoint 이후 기록 수 ÷ replay 속도)
위 타임라인에서는 t=0에 멈춰 t=10.7에 수락을 시작했으니 약 10.7초입니다. replay 양은 checkpoint 간격에 비례합니다. checkpoint를 60초마다 한다고 두면(설계 가정), 칸 하나(평균 초당 약 56.5건)는 최대 약 3,390건을 다시 읽습니다. checkpoint 간격을 늘리면 checkpoint 쓰기는 줄지만 replay가 길어져 공백이 늘고, 줄이면 그 반대입니다.
영향 범위는 칸 수로 정해집니다. 4,096칸 중 하나가 멈추면 전체 대화의 약 0.024%(1 ÷ 4,096)가, worker 한 대가 죽어 256칸이 한꺼번에 옮겨 가면 6.25%(256 ÷ 4,096)가 10초 이상 송신하지 못합니다. worker가 8대면 한 대 장애가 12.5%, 32대면 3.125%입니다. 설계 문서가 제안한 수락 지연 p99 300ms는 전체 요청 기준이라 이 공백이 p99에 잘 드러나지 않지만, 그 칸에 속한 사용자에게는 10초 넘게 "전송 중"이 이어지는 장애입니다. 그래서 칸별 장애 조치 시간을 따로 지표로 봐야 합니다.
7. 한 대화에 트래픽이 몰릴 때의 한계
대화 하나를 writer 하나가 맡는 구조에는 분명한 한계가 있습니다. 한 대화의 명령은 한 번에 하나씩만 처리되므로, worker를 아무리 늘려도 한 대화의 처리량은 나눠 가질 수 없습니다. 이런 대화를 설계 문서에서는 hot conversation이라고 불렀습니다.
한 대화의 처리 상한
mailbox가 기록 확정을 기다린 뒤에 다음 명령을 꺼낸다면, 한 대화가 1초에 처리할 수 있는 명령 수는 다음과 같습니다.
한 대화의 처리 상한 = 1 ÷ 기록 확정 지연
  확정 지연 5ms   → 초당 200건
  확정 지연 20ms  → 초당 50건
제 설계는 책의 요구사항을 따라 그룹 채팅을 최대 100명으로 잡았습니다. 100명이 모두 1초에 한 건씩 보내는 극단적인 대화는 초당 100건이므로, 확정 지연이 5ms면 받을 수 있고 20ms면 받지 못합니다. 확정 지연을 기다리지 않는 방법도 있습니다. 번호를 붙인 뒤 확정을 기다리지 않고 다음 명령에 번호를 붙이는 파이프라인 방식입니다. 이때 상한은 번호를 붙이는 비용으로 정해지지만, 앞 명령의 기록이 실패하면 뒤 명령의 번호도 버려야 합니다. 3절에서 번호의 빈틈을 허용해 둔 것이 이 경우를 받아 줍니다. 두 방식 중 무엇을 쓸지는 로그 저장소의 기록 확정 지연 p99를 재어 보고 정할 값입니다.
사람이 입력하는 속도라면 순서 처리보다 먼저 막히는 곳이 있습니다. 같은 100명 대화에서 한 건은 수신자 99명에게 퍼져 나가므로, 초당 100건이면 전달 작업이 초당 9,900건(100 × 99)입니다. 원문 범위에서는 순서 처리보다 이 증폭이 먼저 한계에 닿습니다. 봇 하나가 같은 대화에 초당 1,000건을 보내면 사정이 달라집니다. 전달 작업은 초당 99,000건이 되고, 확정을 기다리는 mailbox라면 대기열이 끝없이 쌓입니다.
대응: rate limit, shard 격리, 전용 shard
이 범위에서는 다음 대응으로 충분하다고 판단했습니다.
- rate limit: 한 대화나 한 사용자가 보낼 수 있는 초당 메시지 수를 제한합니다. 대화마다 token bucket(일정 속도로 채워지는 토큰을 꺼내 쓰는 방식)을 둡니다.
- shard 격리: 뜨거운 대화가 속한 virtual shard를 다른 worker로 옮겨, 같은 worker에 있던 다른 대화가 함께 느려지지 않게 합니다. 4,096칸 기준이면 함께 옮겨지는 대화는 전체의 약 0.024%입니다.
- 전용 shard: 특히 뜨거운 대화는 담당 표에 예외로 등록해 칸 하나를 따로 줍니다.
앞서 본 Java의 onCommand에 송신 속도 제한을 추가하면 다음과 같습니다. 나머지 processInOrder는 그대로 사용합니다.
void onCommand(Command cmd) {
    if (!tokenBuckets.forConversation(cmd.conversationId()).tryTake(1)) {
        replyRateLimited(cmd); // 단말은 같은 client_message_id로 나중에 재시도한다.
        return;
    }
    mailboxes.submit(cmd.conversationId(), () -> processInOrder(cmd));
}
한도 값(대화당 초당 몇 건)은 실제 대화별 초당 명령 수의 분포를 재고, 그 p99.9보다 위에 둬서 정상 대화가 걸리지 않게 정할 값입니다. 한도를 너무 낮추면 활발한 단체방의 정상 메시지가 거부되고, 너무 높이면 봇 하나가 칸 전체의 대기열을 밀어 올려 같은 칸의 다른 대화까지 느려집니다.
이 대응들은 한 대화의 처리 한계를 올려 주지 않습니다. 뜨거운 대화 때문에 다른 대화까지 느려지는 것을 막을 뿐입니다. 수만 명이 참여하는 방송 채널까지 지원해야 한다면 선택지가 둘로 나뉩니다.
- 대화 전체의 순서를 그대로 유지하고, writer 하나가 처리할 수 있는 양을 늘립니다.
- 메시지를 여러 하위 흐름(substream)으로 나눠 따로 번호를 매기고, 일부 순서가 어긋나는 것을 허용한 뒤 클라이언트에서 합칩니다.
두 번째 방식은 규모를 키우기 쉽지만, 모든 사용자가 같은 순서를 곧바로 보게 하기는 어렵습니다. 그래서 이 선택은 기술보다 제품 요구가 먼저입니다. 제품이 방송 채널에서도 모든 사람이 완전히 같은 순서를 봐야 한다고 요구하는지부터 확인해야 합니다. 저는 이 편의 설계가 책임지는 범위를 100명 그룹까지로 두었습니다.
8. 순서를 무엇으로 검증하는가
설계 문서의 테스트 전략 첫 문장에 "설계 문서의 숫자는 테스트 계획과 연결되어야 한다"고 적었습니다. 순서 보장도 같습니다. "대화별 단일 writer로 순서를 보장한다"는 문장은 테스트로 확인하기 전까지는 주장일 뿐이고, 앞에서 본 lease 길이, 세대 등록 시간, 한 대화의 처리 상한도 모두 테스트로 재어야 정해지는 값입니다.
속성 기반 테스트
속성 기반 테스트(property-based test)는 입력 사례를 사람이 하나씩 적는 대신, 테스트 도구가 임의의 입력을 대량으로 만들어 넣고 결과가 항상 지켜야 할 성질을 만족하는지 검사하는 방식입니다. 여기서는 임의의 재시도, 지연, 순서 뒤바뀜, writer 교체를 섞어 넣고 3절의 세 가지(누락, 충돌, 역행)와 수렴을 확인합니다.
property 대화_순서(시나리오 = 임의의 송신, 재시도, 지연, 강퇴, writer 교체):
    run(시나리오)
    wait_until(모든 단말 동기화 완료)

    for conv in 시나리오.대화들:
        stored   = 저장된 메시지(conv)                  # (client_message_id, seq) 목록
        accepted = ACCEPTED를 받은 요청(conv)

        # 누락: ACCEPTED를 받은 메시지는 모두 저장되어 있다
        assert accepted.client_message_ids ⊆ stored.client_message_ids
        # 중복: 같은 client_message_id로 N번 보내도 결과는 하나다
        assert stored.client_message_ids에 중복이 없다
        # 충돌: seq 하나에 메시지 하나
        assert stored.seqs에 중복이 없다
        # 역행: ACCEPTED를 먼저 받은 메시지가 더 작은 seq를 가진다
        for (a, b) in accepted where a.accepted_at < b.sent_at:
            assert a.seq < b.seq
        # 권한: 강퇴가 기록된 seq 뒤로는 그 사용자의 메시지가 없다
        assert no m in stored where m.sender in kicked_before(m.seq)
        # 수렴: 모든 단말의 화면 순서가 같다
        assert 모든 단말의 표시 목록(conv)이 같다
역행 검사는 "ACCEPTED를 먼저 받은 메시지"와 "그 뒤에 보낸 메시지"만 비교합니다. 동시에 보낸 두 메시지는 1절에서 본 것처럼 어느 쪽이 먼저여도 되므로 비교하지 않습니다. 번호 간격은 검사하지 않습니다.
통합 테스트와 장애 주입 테스트
통합 테스트로는 순서와 관련된 시나리오 세 가지를 적어 두었습니다. ACCEPTED 직전에 연결을 끊고 같은 ID로 재시도하는 경우, 멤버 제거와 메시지 송신을 동시에 실행하는 경우, 여러 단말이 서로 다른 동기화 위치에서 동시에 동기화하는 경우입니다.
장애 주입 테스트는 장애를 일부러 일으킨 뒤 불변 조건이 지켜지는지 확인합니다. 아래 그림은 주입할 장애와 확인할 조건을 짝지은 것입니다.
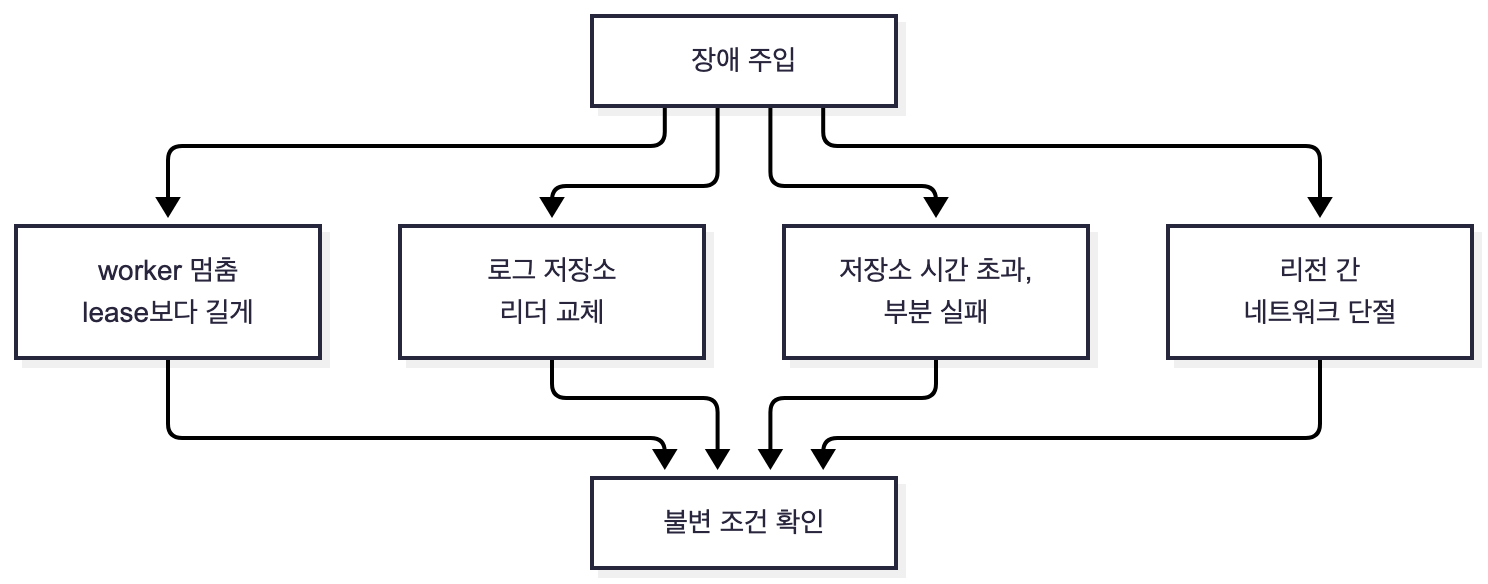
- 맨 왼쪽의 worker 멈춤은 5절과 6절의 이전 세대 writer를 일부러 만드는 시험입니다. GC pause를 흉내 내어 worker를 lease보다 길게 멈췄다가 깨웁니다.
- 확인할 조건은 네 가지입니다. ACCEPTED를 받은 메시지가 최종적으로 조회된다. 같은 메시지가 여러 번 처리되더라도 화면에는 한 번만 보인다. 같은 대화의 모든 단말이 같은 순서로 모이고 ACCEPTED된 메시지가 빠지지 않는다. 다른 칸의 정상 대화는 뜨거운 칸 때문에 멈추지 않는다.
- 이 시험에서 함께 보는 지표가 "세대 번호로 거부된 쓰기 수"입니다. worker를 멈췄다 깨웠는데도 이 값이 0이면, 세대 번호를 worker 단위로 잘못 묶어 아무것도 막지 않는 상태를 의심해야 합니다.
테스트를 언제 끝낼지도 정해 두었습니다. 부하 발생기가 멈췄다고 끝이 아니라, 밀린 작업이 정상 범위로 돌아왔는지, 수락 건수와 최종 저장된 고유 건수가 같은지, 화면 중복과 누락과 역행이 없는지, 장애 중에 생긴 재시도가 같은 메시지 하나로 합쳐졌는지를 확인한 뒤에 끝냅니다.
9. 정리와 남은 질문
순서 문제를 따라가면서 판단이 여러 번 좁혀졌습니다. 처음에는 "순서"를 현실의 선후로 생각했는데, 필요한 것은 모든 참여자가 같은 서버 순서를 보는 것이었습니다. 그 순서는 대화 안에서만 필요했고, 대화마다 번호를 붙이는 곳이 하나라는 전제 위에서만 책의 지역적 순서 번호가 쉬워졌습니다. 그 "하나"를 만들려고 virtual shard와 lease를 두었고, lease만으로는 이전 세대 writer를 막을 수 없어서 세대 번호가 필요했습니다.
가장 크게 바뀐 것은 fencing을 보는 방식입니다. 설계 문서에 "fencing"이라는 단어만 적어 두었을 때는 이 편의 6절 어느 내용도 정해져 있지 않았습니다. 담당자 결정, 이전 세대 차단, 자기 검사를 나누고 나서야 자기 검사를 방어 장치에서 빼는 결정을 내렸고, 그 결정이 부수효과 규칙과 기동 순서처럼 실제로 지켜야 할 규칙을 드러냈습니다.
세대 번호를 검사하는 위치는 로그 저장소가 세대 번호로 거부하는 쪽을 기본으로 정했고, 저장 단계는 같은 순번의 두 번째 저장만 막습니다. 저장 단계 방식은 6절의 세 조건이 모두 있어야 성립했고, 그중 ACCEPTED를 저장 결과 뒤로 옮기는 조건 때문에 수락 지연의 꼬리가 길었습니다(초당 1,000건에서 저장 완료까지 중앙값 0.83ms, p99 146.9ms). 두 위치를 함께 두면 정상 메시지를 잃는 경우만 늘었습니다. 이유와 같은 실행에서 잰 로그 저장소 쪽 숫자는 3편에 있습니다.
아직 정하지 않은 것도 있습니다.
- 로그 저장소를 무엇으로 만들 것인가. 이 편에서는 로그 저장소를 "세대 번호가 낮은 쓰기를 거부할 수 있는 추가 전용 로그"라고만 가정했습니다. 이미 있는 제품을 이 자리에 넣으면 어디까지 맞는지는 3편에서 다룹니다.
참고 자료
- 알렉스 쉬, 『가상 면접 사례로 배우는 대규모 시스템 설계 기초』, 이병준 옮김, 인사이트, 2021.
- Martin Kleppmann, "How to do distributed locking" (2016): https://martin.kleppmann.com/2016/02/08/how-to-do-distributed-locking.html
- 직접 재현해 본 결과는 3편과 실험 저장소에 있습니다. chat-message-ordering (저장 단계 거부 재현은 results/Q5.md, 비교하는 행의 잠금과 수락 지연 측정은 results/Q7.md, 반복 측정 원 데이터는 results/data/q5_race_soak.csv): https://github.com/iohyeon/chat-message-ordering
- 曾钦松, 万亿级调用下的优雅:微信序列号生成器架构设计及演变, 텐센트 클라우드 개발자 커뮤니티 게재본(2017년 수정): https://cloud.tencent.com.cn/developer/article/1004444
- 카카오, 카카오톡 메시징 시스템 재건축 이야기 (if(kakao) 2022): https://speakerdeck.com/kakao/kakaotog-mesijing-siseutem-jaegeoncug-iyagi
- Twitter Snowflake 저장소, snowflake-2010 브랜치(책의 참고문헌 "Announcing Snowflake"는 원래 링크가 열리지 않아 저장소 링크로 대신합니다): https://github.com/twitter-archive/snowflake/tree/snowflake-2010
'스터디' 카테고리의 다른 글
| [대규모 시스템 설계] 검색어 자동완성 시스템 설계 (0) | 2026.10.11 |
|---|---|
| [대규모 시스템 설계 스터디] 채팅 시스템 설계 3편 Kafka 대입 (0) | 2026.10.10 |
| [대규모 시스템 설계 스터디] 채팅 시스템 설계 1편 설계 전반 (0) | 2026.10.09 |
| [대규모 시스템 설계 스터디] 뉴스 피드 시스템 설계 (0) | 2026.10.09 |
| [Sutskever's List 스터디] dropout의 자리와 CTC를 계산해 본 후기 (0) | 2026.10.05 |